Если вам нужно разобрать скриншот, проверить страницу, подготовить текст по материалам или исправить небольшую ошибку в коде, GPT-6.1 Terra стоит рассмотреть как рабочий вариант. Для сложной разработки и неоднозначных задач OpenAI рекомендует более мощные GPT-6.1 Sol и GPT-6 Astra.
Главное преимущество Terra — сочетание работы с изображениями и интерфейсами с более низкой стоимостью API. Это не означает, что модель одинаково хорошо решит любую задачу: на первых независимых тестах она заметно прибавила относительно GPT-5.6 Terra, но Sol получила более высокие результаты в программировании и аналитике.
Модель представили 26 октября 2026 года. Мы изучили анонс OpenAI, документацию и первые внешние проверки. Источники проверены 27 октября. После подготовки обзора мы провели небольшую практическую пробу; её условия и ограничения описаны ниже.
Где Terra может пригодиться
Работа с экраном. Terra может анализировать изображения интерфейсов и, при доступе к инструментам, выполнять действия в приложениях: переходить между страницами, заполнять поля и проверять результат. Например, маркетолог может поручить ей сверить видимые настройки кампании с утверждённым заданием. Доступ к кабинету, конкретные действия и ограничения определяет среда, в которой запущена модель.
Документы и тексты. Модель помогает собрать черновик по исходным материалам, выделить расхождения и подготовить пояснение для команды. Точность цифр и соответствие исходнику нужно проверять: улучшение на тестах не исключает ошибок в отдельном отчёте.
Небольшие задачи в разработке. Terra подходит для точечной правки и проверки кода. Сложный проект, где решение затрагивает много компонентов или требует архитектурного выбора, разумно сравнить с Sol или Astra. Такую границу проводит и руководство OpenAI по выбору модели.
Эти примеры показывают возможное применение, а не результат собственного теста WiseLab. При работе с реальным кабинетом проверяйте сохранённые настройки и, если она доступна, историю изменений: сообщение агента об успехе ещё не подтверждает, что система записала нужные данные.
Что изменилось по сравнению с GPT-5.6 Terra
В анонсе OpenAI приведены результаты нескольких тестов. Они показывают прогресс на конкретных наборах задач, но не гарантируют такой же прирост в каждом рабочем процессе.
| Проверка OpenAI | GPT-6.1 Terra | С чем сравнили |
|---|---|---|
| Agents’ Last Exam: профессиональные задачи с использованием компьютера | На 15 процентных пунктов выше | GPT-5.6 Terra; среднее усилие рассуждений, около трети стоимости задачи предшественницы |
| Terminal-Bench 4.0: задачи разработки через терминал | 50,3% решённых задач | 21,5% у GPT-5.6 Terra; максимальное усилие рассуждений |
| Специальный внутренний набор вопросов, провоцирующих ошибки | 16,7% ошибочных ответов | 53,6% у GPT-5.6 Terra; низкое усилие рассуждений |
Под усилием рассуждений здесь имеется в виду настройка, которая влияет на объём работы модели над ответом. При сравнении её важно указывать: результат на максимальном уровне нельзя автоматически переносить на быстрый режим.
Особенно осторожно стоит читать процент фактических ошибок. OpenAI проверяла вопросы, специально подобранные для того, чтобы спровоцировать ошибку. Эти 16,7% не являются частотой ошибок во всех диалогах и не заменяют проверку источников.
На Agents’ Last Exam OpenAI также сообщает, что Terra выполняла задачи более чем втрое быстрее GPT-6.1 Sol и GPT-6 Astra. Это заявление разработчика для данного теста, а не обещание трёхкратной скорости в любом кабинете или на любом документе.
Что показали независимые тесты
Artificial Analysis: дешевле предшественницы на своём наборе
В исследовании Artificial Analysis GPT-6.1 Terra при максимальном усилии получила на шесть пунктов больше GPT-5.6 Terra в Intelligence Index. Средняя стоимость задачи в этом наборе составила 0,40 USD против 1,40 USD у предыдущей модели.
В отдельном Coding Agent Index новая Terra получила 48 баллов, GPT-6.1 Sol — 54. Это не процент успешных задач и не оценка любого проекта: индекс объединяет результаты выбранных авторами тестов. Вывод для команды разработки — Terra стоит проверить на ограниченных исправлениях, а сложные изменения сравнить с Sol.
Plotly: хороша в прямых вопросах, но пропустила часть закономерностей
Plotly проверила модели на 43 вопросах по аналитике. Terra решила 40 вопросов за 1,31 USD, Sol — все 43 за 2,61 USD. Указана стоимость всего теста в условиях Plotly, а не типичная стоимость пользовательского отчёта.
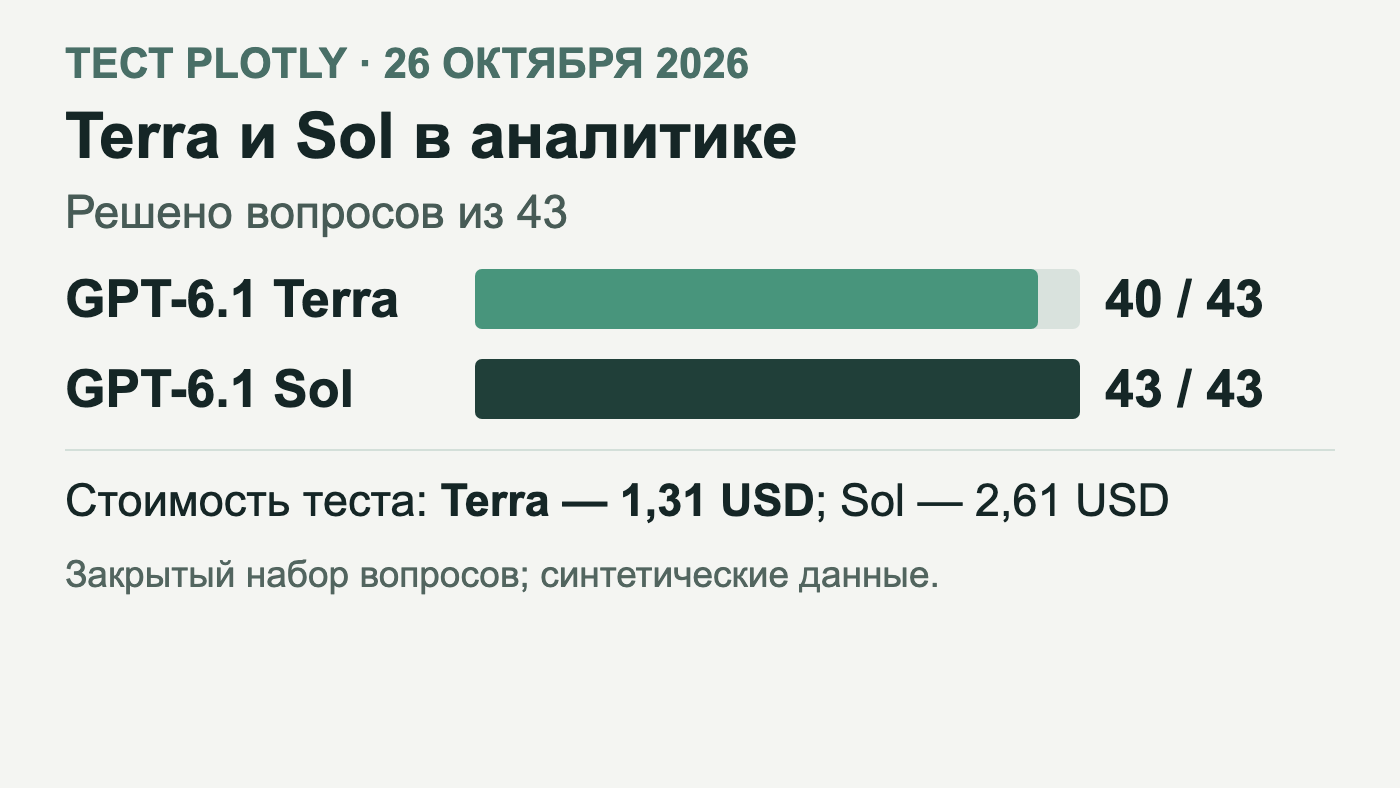
В тесте Plotly Terra решила 40 из 43 вопросов, Sol — 43.
Данные в тесте синтетические, сам набор вопросов закрыт. Terra пропустила две из пяти скрытых закономерностей. Для аналитика это полезное ограничение: модель может корректно ответить на прямой вопрос и всё же не заметить важный сигнал, который ей не предложили искать.
Для рекламного отчёта поэтому недостаточно попросить «найди всё важное». Лучше заранее перечислить проверки: сравнение периодов, изменения расходов и результатов, определения событий, пропуски, дубли и ограничения атрибуции. Необычные выводы затем сверяют с исходными данными.
Terra, Sol или Luna: как выбрать
| Ситуация | С чего начать | Что проверить |
|---|---|---|
| Скриншот, интерфейс, ограниченное действие | Terra | Доступ к нужному инструменту и сохранённый результат |
| Черновик по источникам или небольшая правка кода | Terra | Факты, полноту, тесты и отсутствие регрессий |
| Сложный анализ или разработка с несколькими зависимостями | Sol; для наиболее трудной задачи — Astra | Качество решения на ваших материалах и итоговые затраты |
| Частая простая операция с жёстким ограничением расходов | Сравнить Luna и Terra | Долю ошибок и стоимость всего процесса, включая исправления |
Это ориентиры редакции по сочетанию официального позиционирования и опубликованных тестов. Данные не доказывают, что одна модель всегда лучше другой. В руководстве OpenAI Terra предлагается, в частности, для коротких текстов по материалам, действий в интерфейсе с определённым результатом и ограниченных исправлений кода.
Сколько стоит и где доступна
По карточке API стандартные тарифы Terra составляют 1,00 USD за миллион входных токенов и 5,00 USD за миллион выходных токенов. Кешированный вход стоит 0,05 USD за миллион. Для GPT-6.1 Sol стандартные цены входа и выхода — 2,00 и 10,00 USD соответственно.
Токен — единица, в которой измеряется объём обрабатываемого текста. Итоговая стоимость зависит от числа токенов и условий запроса; дополнительные инструменты могут тарифицироваться отдельно. В API при входе свыше 272 тысяч токенов действуют повышенные ставки. Сравнивать только цену токена недостаточно: модель может потратить больше шагов или потребовать дополнительной проверки.
Цены API не равны отдельным списаниям за каждое действие в подписке Codex или ChatGPT Work. OpenAI сообщает, что в рамках доступного лимита Terra позволяет выполнить больше задач, чем прежняя Terra и более крупные модели, но расход зависит от работы.
В API контекстное окно Terra составляет 1 050 000 токенов, максимальный вывод — 128 000 токенов. Это параметры API: размер контекста в конкретном приложении может отличаться. Модель принимает текст и изображения и выдаёт текст; прямой ввод аудио и видео через API в спецификации не поддерживается. Упомянутое OpenAI редактирование видео описывает работу с инструментами и не означает прямую загрузку любого видео в модель.
OpenAI объявила доступность GPT-6.1 Terra в ChatGPT Work и Codex для пользователей Plus, Pro, Enterprise и Edu. Фактическая доступность зависит от тарифа и настроек рабочего пространства.
При проверке аналитического отчёта важно сверить выводы с исходными данными.
Практическая проба: Terra и Sol на трёх рабочих заданиях
27 октября 2026 года мы предложили Terra и Sol одинаковый набор: разобрать обезличенные рекламные данные, оценить снимок мобильной страницы и подготовить короткий текст по заданным фактам. Для каждой модели был запрошен один запуск в Codex с уровнем рассуждений high. В задании моделям запретили поиск и дополнительные источники; техническое отключение инструментов мы не проверяли.
В рекламной задаче обе модели различили события нажатия на телефон и подтверждённые звонки. На снимке они заметили мелкие подписи диаграммы и крупную панель cookies. Снимок показывал прежнюю версию статьи: к моменту пробы диаграмму уже заменили. В редакционном задании Sol привела оба результата сравнения Plotly; Terra описала результат только для себя.
| Задание | Terra | Sol |
|---|---|---|
| Аналитика | 10 из 10 | 10 из 10 |
| Мобильный снимок | 6 из 6 | 6 из 6 |
| Текст для статьи | 7 из 8 | 8 из 8 |
| Всего | 23 из 24 | 24 из 24 |
Другой AI-исполнитель оценивал ответы под нейтральными метками по критериям, заданным до получения результатов: точность аналитики, наблюдения по снимку и сохранение фактов в тексте. Это оценка ответов на три конкретных задания, а не универсальный рейтинг. Одного запуска на модель недостаточно, чтобы заключить, что одна из них стабильно лучше другой. Скорость, число токенов и стоимость мы не измеряли.
Интерфейс делегирования не предоставил независимых runtime-метаданных об исполненной модели, поэтому названия моделей в сравнении основаны на настройках запусков. Исходные клиентские данные и рекламные показатели в статье не публикуются.
Как сравнить модели на своих задачах
Для небольшого пилота возьмите пять–десять реальных задач, которые команда уже умеет проверять. Такой набор поможет найти практические проблемы, но не даст статистически надёжной оценки качества модели. Например, два отчёта по рекламе, несколько снимков настроек и одну ограниченную правку страницы. Обезличьте материалы, если это требуется правилами доступа вашей организации.
Дайте Terra и Sol одинаковые исходные данные, запрос и доступные инструменты. До запуска запишите критерии: какие числа должны совпасть, какие ограничения обязательны и что считается успешным результатом. Для действий в интерфейсе включите проверку сохранённого состояния; для кода — запуск подходящих тестов.
Затем сравните ответы по каждому критерию и отметьте время проверки и исправлений. Если измеряете расходы API, сохраняйте также использованные токены и стоимость инструментов. Так можно понять, где Terra действительно экономит ресурсы, а где более сильная модель окупается меньшим числом исправлений.
Подробнее о том, как устроить такую проверку, — в материале WiseLab об оценке ответов ИИ.
Фотографии и условия использования
- Simon Hattinga Verschure, Typing on a laptop.jpg), CC0 1.0.
- Jakub Żerdzicki, Office desk with financial charts, лицензия Unsplash.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…