Перед изменением robots.txt согласуйте список страниц каталога, которые должны оставаться доступными Googlebot, и проверьте каждую на точной версии файла. В набор включите категорию, следующую страницу списка, товар, фильтр, поиск и корзину: одна открытая главная страница не подтверждает правильность остальных правил.
Для маркетолога результат приёмки — таблица «URL → ожидаемый обход → фактический обход», сохранённый файл и список расхождений. Она нужна после изменения фильтров, адресов категорий или настроек SEO-модуля, когда широкое правило может затронуть нужные посадочные страницы.
Сначала запишите задачу каталога
Начните с основной инструкции по проверке robots.txt: установите нужный хост, протокол и фактический ответ файла. Дальше выберите страницы по бизнес-задаче. Категория, которая должна привлекать органический спрос, и служебный поиск могут требовать разных решений.
Ниже — вымышленный магазин и учебное задание. Категорию кресел, её вторую страницу и карточку товара решили оставить доступными обходу. Цветовой фильтр, другую категорию, поиск и корзину — закрыть. Это условия примера, без рекомендации закрывать такие страницы в любом магазине: решение зависит от структуры и задач вашего сайта.
Все адреса относятся к одному https://shop.example. Результат не переносится автоматически на другой поддомен или протокол.
Две ошибки, которые скрывает общий просмотр файла
Учебная первая версия:
User-agent: *
Disallow: /search
Disallow: /cart/

User-agent: Googlebot
Disallow: /catalog/
Allow: /catalog/chairs$
В описании Google выбор группы и выбор правила разделены. Googlebot использует свою подходящую специальную группу; глобальная группа * с ней не складывается. Поэтому запреты поиска и корзины в этом файле не стали запретами для Googlebot.
Вторая ошибка связана с окончанием адреса. $ обозначает конец URL: разрешение /catalog/chairs$ подходит категории без параметров, но уже не подходит /catalog/chairs?page=2. На второй адрес остаётся запрет /catalog/.
Порядок строк не исправляет такую логику. По RFC 9309 при выборе совпавшего правила учитывается его специфичность; при эквивалентных Allow и Disallow предпочтение следует отдавать Allow. Для приёмки полезнее проверять конкретный URL, чем оценивать файл по наличию строки «Allow».
Проверка семи URL
Мы собрали и запустили открытый парсер Google robots.txt на двух локальных файлах. Исходные файлы парсера не изменяли; их контрольные суммы, исходники, входные данные и вывод сохранены в комплекте проверки. Это фактически выполненный локальный тест, без обращения к настоящему Googlebot или рабочему магазину.
| Путь | Ожидается по заданию | Первая версия | После исправления |
|---|---|---|---|
/catalog/chairs | Разрешить | Разрешено | Разрешено |
/catalog/chairs?page=2 | Разрешить | Запрещено | Разрешено |
/catalog/chairs?color=black | Запретить | Запрещено | Запрещено |
/catalog/tables | Запретить | Запрещено | Запрещено |
/product/chair-a | Разрешить | Разрешено | Разрешено |
/search?q=chair | Запретить | Разрешено | Запрещено |
/cart/ | Запретить | Разрешено | Запрещено |
Первая версия дала три расхождения из семи проверок. Категория без параметров и товар прошли, но вторая порция каталога оказалась закрыта, а два служебных адреса — открыты вопреки заданию.
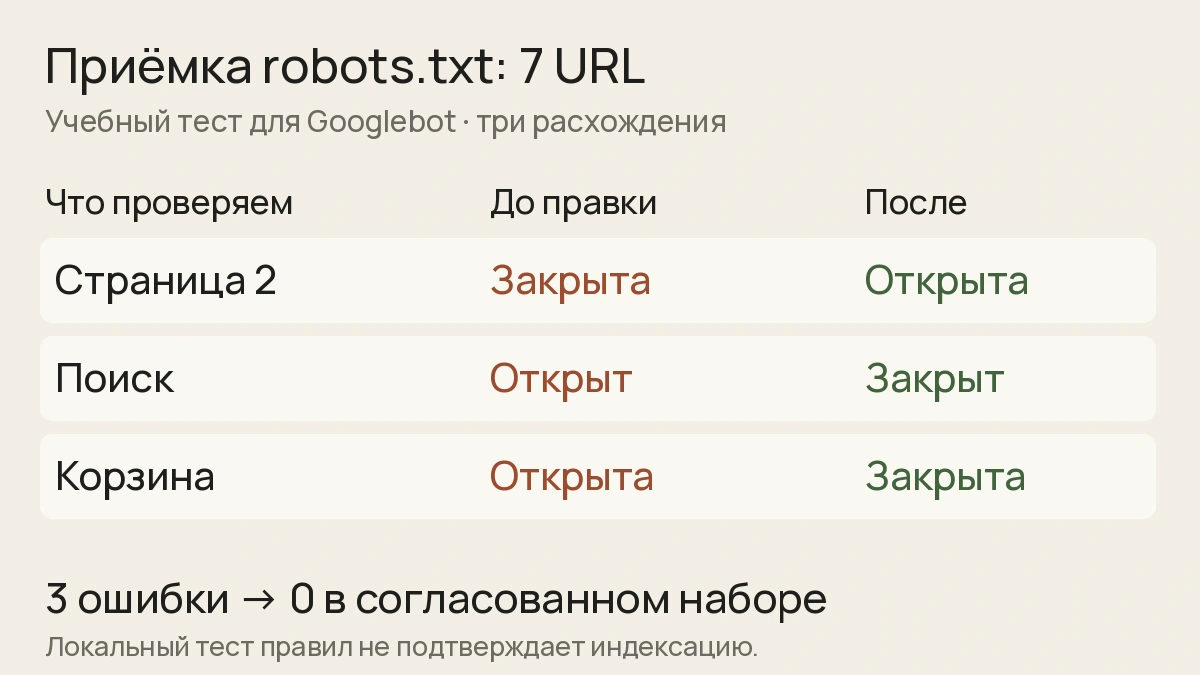
Учебный набор: показаны три исправленных расхождения; итог относится только к семи адресам из таблицы.
Как исправили учебный файл
В специальную группу Googlebot добавили нужные запреты и точное разрешение второй страницы:
User-agent: Googlebot
Disallow: /catalog/
Allow: /catalog/chairs$
Allow: /catalog/chairs?page=2$
Disallow: /search
Disallow: /cart/
Глобальную группу из первой версии оставили. После изменения все семь решений совпали с заданием; отдельные проверки подтвердили, что фильтр и закрытая категория не открылись вместе со второй страницей.
Разрешение page=2 здесь намеренно точное. Это исправление конечного учебного набора, а не готовый шаблон пагинации большого магазина. Третью страницу, сочетания параметров, сортировку, UTM, регистр и варианты со слешем нужно добавить в рабочие случаи до выбора общего шаблона. Широкое разрешение всего префикса может открыть больше адресов, чем согласовано.
Для повторения одной проверки у собранного инструмента есть такой вызов:
./robots robots-before.txt Googlebot 'https://shop.example/catalog/chairs?page=2'В нашем запуске он вернул DISALLOWED, с robots-after.txt — ALLOWED. Утилита проверяет сопоставление локального файла и переданного адреса; это не проверка сетевой доступности страницы. Требования к сборке и формату URL приведены в README официального репозитория.
Что передать разработчику и проверить после выпуска
К заданию приложите две версии robots.txt, время получения, SHA-256, точный хост и имя робота. Для каждого URL сохраните ожидаемый результат, фактический ответ и причину ожидания. Вместо «открыть каталог» получится конкретная строка: «вторая страница кресел должна обходиться, сейчас закрыта правилом /catalog/».
После правки повторите весь набор, включая адреса, которые проходили раньше. Затем получите опубликованный robots.txt с нужного хоста и повторите проверку на нём: локальный файл может отличаться от ответа CMS или CDN. Сохраните этот ответ отдельно, чтобы команда обсуждала одну версию.
Следующий шаг — проверка точного URL в Search Console. Допуск по локальным правилам не подтверждает, что робот уже получил обновлённый файл, страница успешно загружается или включена в индекс. Ответы сервера, кэширование, canonical, noindex и качество страницы требуют своих проверок.
Для каталога со страницами списка отдельно примите маршрут пагинации: разрешённый обход не создаёт отсутствующую ссылку на следующую порцию товаров.
Такой локальный контроль доступен команде в Беларуси без покупки сервиса. Он заканчивается проверяемым списком решений по нужным посадочным страницам; позиции, поисковый трафик и срок индексации этим тестом не измеряются.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…