Два похожих статуса в отчёте индексации Search Console требуют разных первых проверок. Если URL обнаружен, но не просканирован, разберите путь до обхода; если просканирован, но не проиндексирован, изучите страницу, которую Google уже получил, и сигналы выбора канонического URL.
Сам статус не называет точную причину. Он показывает этап, на котором остановилась обработка, и помогает не тратить время на одинаковый чек-лист для разных ситуаций.
Что означают два статуса
Google описывает «Обнаружена — сейчас не проиндексирована» как URL, который уже найден, но ещё не просканирован. Дата последнего обхода в таком отчёте пустая. Для «Просканирована — сейчас не проиндексирована» обход уже состоялся, однако URL не вошёл в индекс; повторно отправлять его на обход только из-за этого статуса Google не советует.
| Статус | Что уже произошло | Первый вопрос | Чего статус не доказывает |
|---|---|---|---|
| Обнаружена | Google знает URL | Почему до него ещё не дошёл обход | Что сервер точно перегружен или URL обязательно будет просканирован в конкретный срок |
| Просканирована | Google получил страницу | Почему она не выбрана для индекса | Что причина обязательно в качестве текста, canonical или дубле |
Для одного адреса начинайте с проверки URL в Search Console. Если страниц много, сначала разделите выгрузку по статусу и шаблону: товары, категории, фильтры, статьи, теги. Так единичный пример не будет подменять проблему всего раздела.
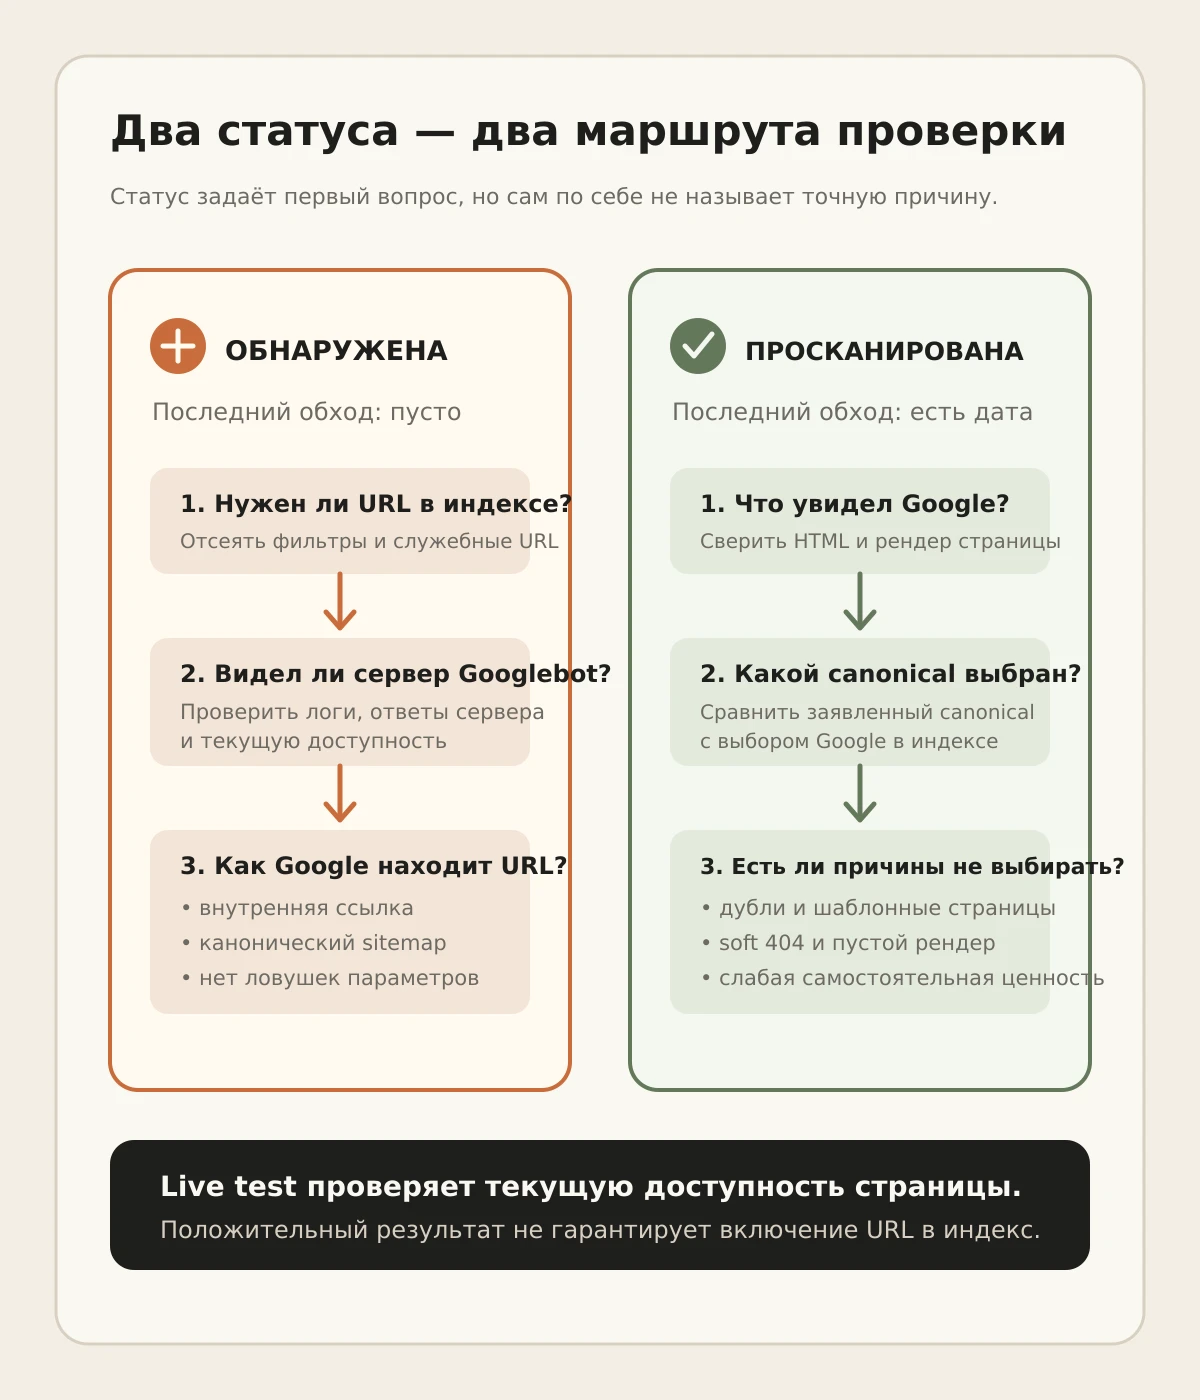
Статус выбирает маршрут проверки: доступность и обнаружение до обхода либо содержимое и канонизация после него.
Сохраните снимок до исправлений
Выгрузите примеры из отчёта и добавьте к каждому URL поля, которые можно проверить повторно:
- статус и дату снимка;
- дату последнего обхода;
- HTTP-ответ живой страницы;
- разрешение в robots.txt и наличие
noindex; - присутствие в sitemap;
- число найденных внутренних ссылок;
- заявленный canonical и выбранный Google canonical, если он доступен;
- шаблон страницы и результат рендера.
Google ограничивает таблицу примеров одной причины тысячей URL и не обещает показать в ней весь набор. Поэтому фиксируйте дату экспорта и рассматривайте выгрузку как выборку, а не полный реестр сайта.
Маршрут 1: URL обнаружен, но не просканирован
Сначала решите, нужен ли адрес в индексе. Параметры сортировки, бесконечные фильтры и служебные варианты могут раздувать очередь обхода; добавлять их в sitemap и усиливать внутренними ссылками не следует.
Для нужного URL проверьте четыре слоя.
1. Текущая доступность
Откройте live test в URL Inspection и убедитесь, что страница отдаёт ожидаемый ответ, обход разрешён, а рендер не падает. Затем проверьте серверные логи: был ли запрос подтверждённого Googlebot к этому URL или хотя бы к тому же шаблону. Пустая дата в Search Console говорит об отсутствии зафиксированного обхода в отчёте; она не заменяет анализ логов.
2. Путь обнаружения
Нужная страница должна иметь обычную HTML-ссылку с релевантного раздела. В sitemap оставляйте канонические URL с корректным lastmod. Отдельно проверьте, не создаёт ли сайт множество комбинаций параметров, календарей или фильтров, которые конкурируют за обход.
3. Нагрузка и ошибки группы
Смотрите не один URL, а шаблон. Если много нужных страниц остаются обнаруженными, сопоставьте период с 5xx, временем ответа и Crawl Stats. Google отдельно рекомендует анализировать crawl budget для сайтов, где значительная доля URL попала в этот статус, но не задаёт универсальный порог для небольшого сайта.
4. Повторная проверка после изменения
После исправления зафиксируйте дату, обновите sitemap и проверьте несколько приоритетных URL. Массовые запросы на индексацию не заменяют нормальную структуру ссылок и sitemap.
Маршрут 2: URL просканирован, но не проиндексирован
Здесь обход уже произошёл. Начните с даты последнего обхода и сохранённой Google версии страницы, затем сравните её с live test.
1. Что получил робот
Проверьте HTTP-ответ, HTML, загруженные ресурсы и скриншот рендера. Живая страница могла измениться после последнего обхода, поэтому расхождение между индексными данными и live test само по себе ещё не ошибка отчёта.
2. Как выбран canonical
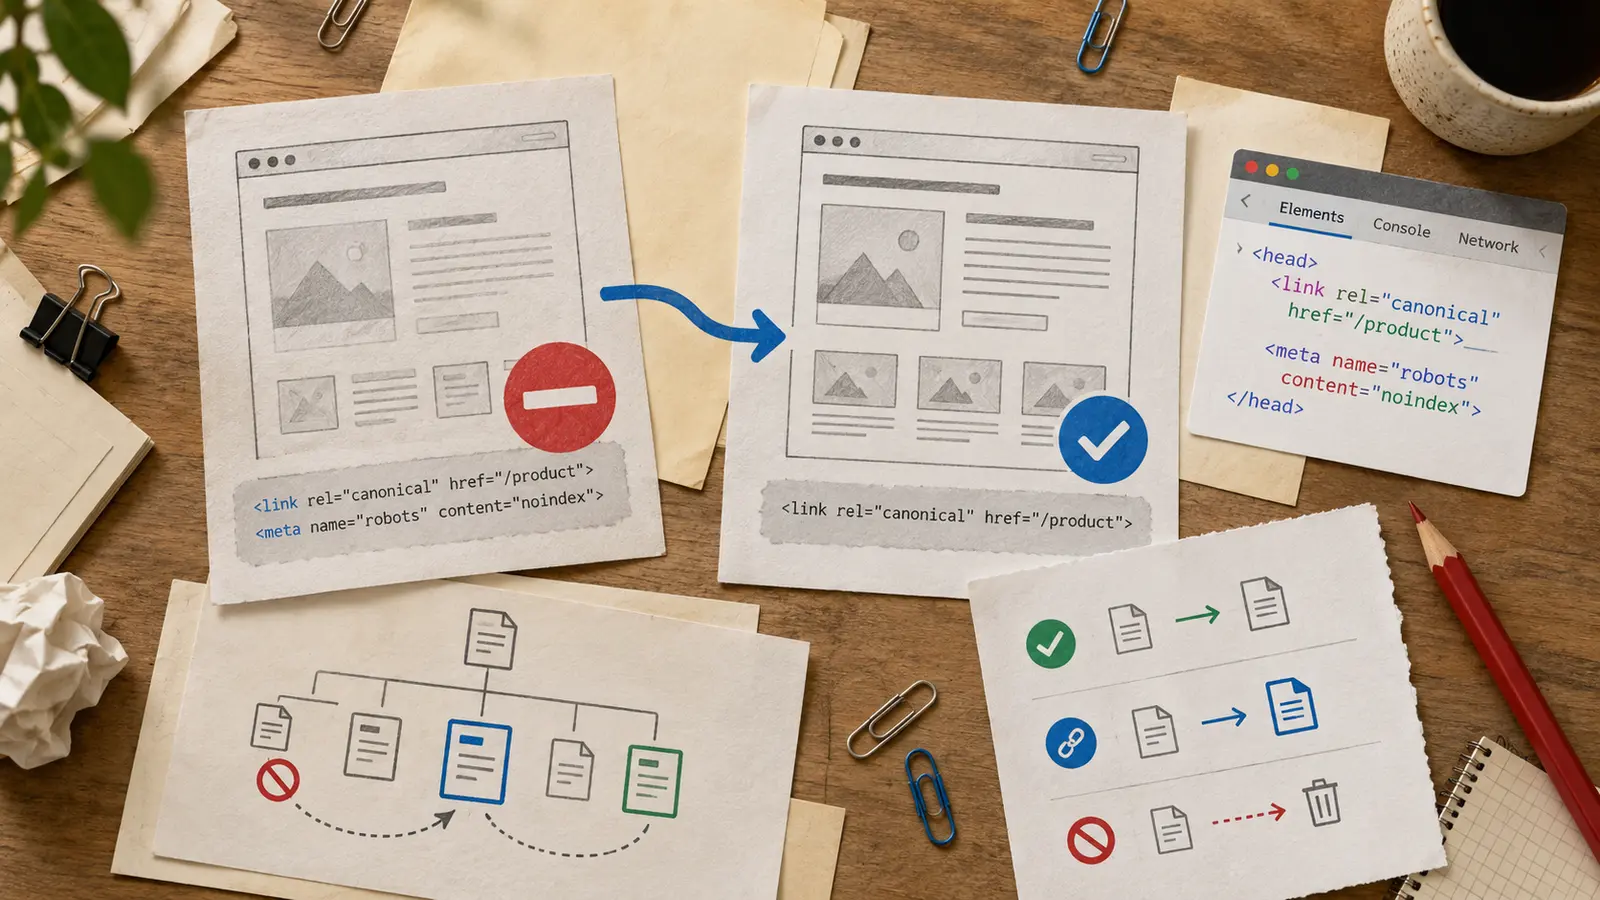
Сравните заявленный canonical с выбранным Google. Выбранный canonical определяется по индексным данным; live test не умеет предсказывать этот выбор. Если Google считает другой URL основным, сопоставьте содержимое, внутренние ссылки, sitemap, редиректы и canonical всей группы. Для этого пригодится разбор конфликта canonical и noindex.
3. Есть ли самостоятельная страница
Проверьте, не является ли URL дублем, пустой карточкой, soft 404 или шаблонной страницей без самостоятельной пользы. Это гипотезы для проверки, а не расшифровка статуса. Положительный live test подтверждает доступность и возможность обработки, но не гарантирует включение в индекс и не проверяет все условия, включая дубли и окончательный выбор canonical.
4. Что делать после исправления
Запрос индексации уместен для нескольких важных URL после фактического изменения. Для большого набора Google рекомендует sitemap с актуальным lastmod. Срок и результат не гарантируются; отслеживайте дату следующего обхода и переход страницы в другой статус.
Учебный пример для пакетной проверки
В комплекте примера шесть условных URL. Скрипт на Python не угадывает причину Google: он лишь направляет строки в нужную ветку и отмечает факты, уже собранные редактором или аналитиком.
import csv

def route(row):
    flags = []
    if row["status"] == "Обнаружена":
        branch = "обход"
        if row["in_sitemap"] != "yes":
            flags.append("нет в sitemap")
        if int(row["internal_links"]) == 0:
            flags.append("нет внутренних ссылок")
    elif row["status"] == "Просканирована":
        branch = "решение об индексации"
        if row["user_canonical"] == "other":
            flags.append("canonical на другой URL")
        if row["rendered_content"] in {"template", "duplicate"}:
            flags.append("проверить самостоятельность страницы")
    else:
        branch = "другой статус"
    return branch, flags
Для Обнаружена скрипт поднимает только проверяемые сигналы до обхода: отсутствие URL в sitemap и отсутствие внутренних ссылок. Для Просканирована он отмечает canonical на другой адрес и шаблонный либо дублирующийся рендер. Нулевой список флагов означает лишь, что в снимке нет этих признаков; он не обещает индексацию.
Как закончить проверку
Сформулируйте результат по шаблону: «На дату N у группы X статус Y; проверены A, B и C; изменено D; следующая проверка после нового обхода». Не смешивайте в одном выводе данные последнего обхода и live test — у них разные моменты времени.
Если причина всё ещё неясна, вернитесь к общему разбору почему страница не индексируется. После технического исправления используйте инструкцию по ускорению переобхода, помня, что запрос остаётся сигналом, а не гарантией срока.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…