Как найти редиректы, 404 и noindex в sitemap
Sitemap может открываться без ошибок, а Search Console — показывать статус «Успешно». Это подтверждает, что Google прочитал файл, но не гарантирует обход и индексирование каждого адреса. Перед отправкой нового sitemap полезно проверить весь список: отвечает ли URL кодом 200, разрешена ли индексация и совпадает ли адрес с canonical.
Ниже — воспроизводимая проверка на учебном наборе из пяти страниц. Она превращает sitemap и сохранённый снимок ответов в CSV: редактор или разработчик сразу видит, какой URL оставить, заменить или удалить.
Что означает успешный sitemap
Google Search Console считает sitemap успешно обработанным, когда файл удалось получить и прочитать. Найденные URL при этом не обязаны попасть в индекс. Поэтому статус файла отвечает на вопрос «прочитан ли список», а состояние страниц приходится проверять отдельно.
Для обычной индексируемой страницы в sitemap ожидаются согласованные сигналы:
| Проверка | Что считать нормой | Что делать при отклонении |
|---|---|---|
| HTTP | Конечный ответ 200 | Заменить редирект; удалить 404/410; исправить ошибку сервера |
| robots | Нет noindex | Снять запрет либо убрать страницу из sitemap |
| canonical | Совпадает с URL из sitemap | Оставить в файле канонический адрес |
| адрес | Абсолютный URL нужного сайта | Исправить домен, протокол или путь |
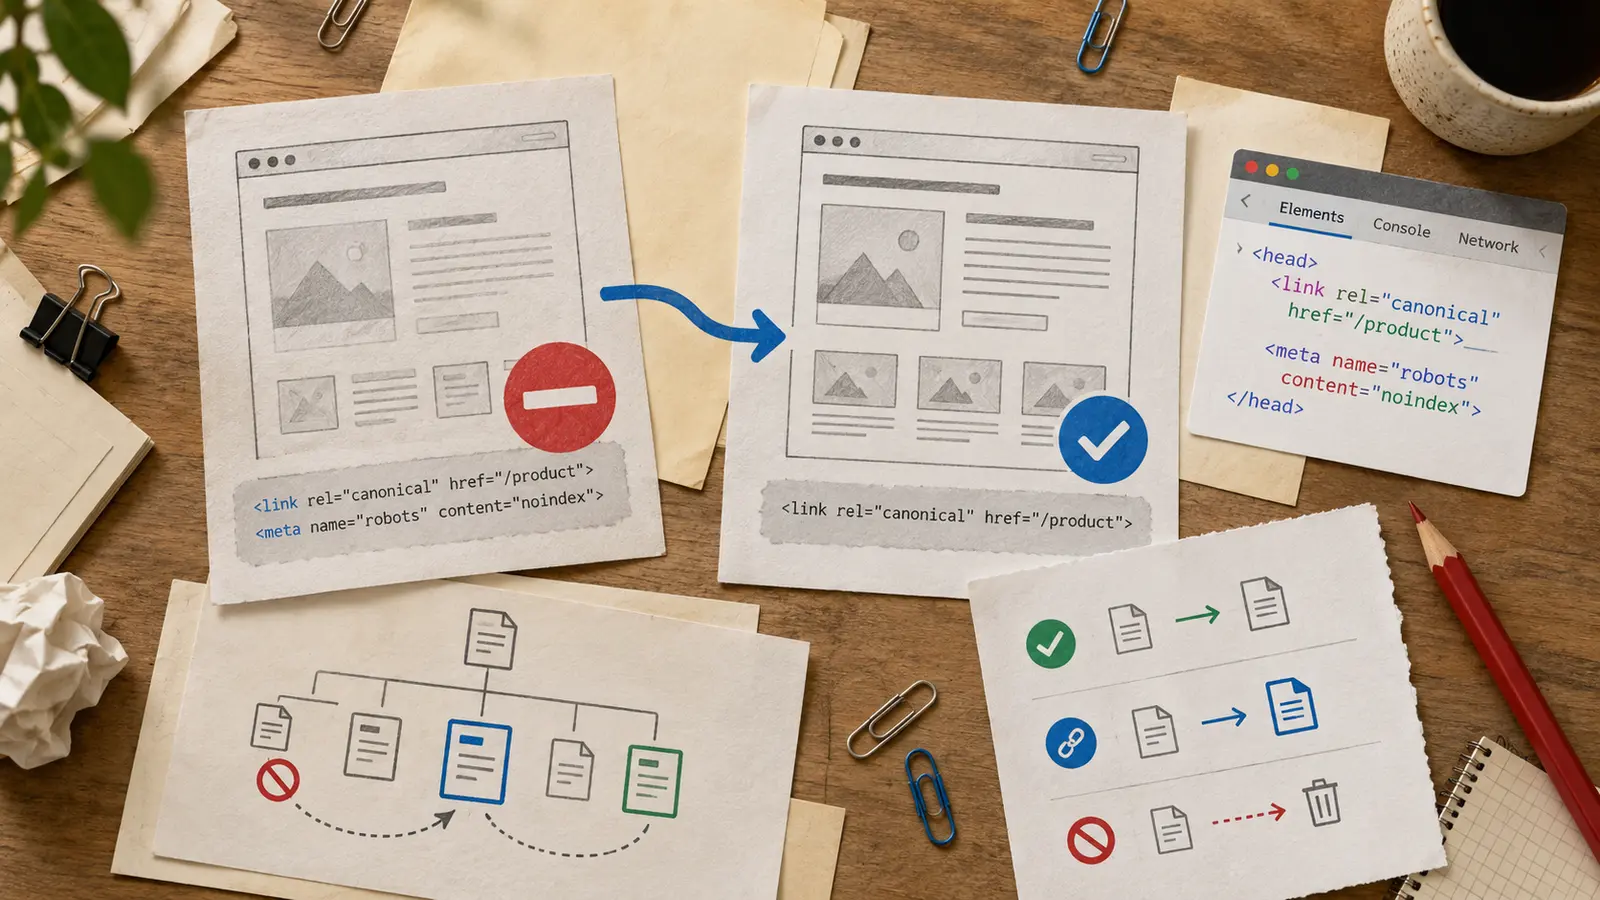
Google рекомендует включать в sitemap предпочтительные канонические URL. Редирект и rel="canonical" считаются сильными сигналами канонизации, а присутствие в sitemap — слабым. Если сигналы расходятся, файл перестаёт быть точным списком страниц, которые сайт предлагает индексировать.
Учебная проверка пяти URL
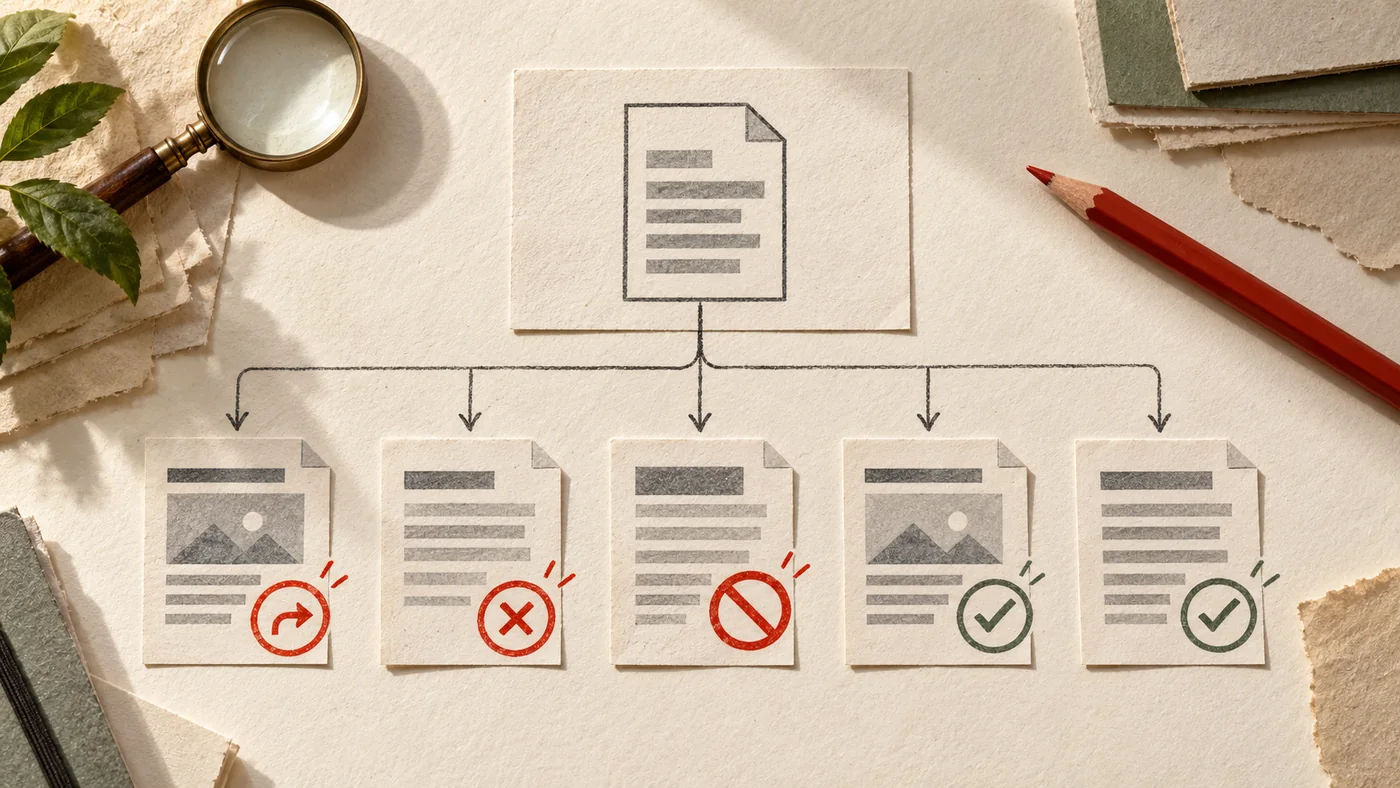
В примере одна страница готова к отправке. Остальные четыре требуют решения: заменить редирект, удалить 404, согласовать noindex и заменить URL с UTM-меткой на canonical.
Схема результата: один URL остаётся в sitemap, четыре исправляются до отправки.
Это учебный набор на домене shop.example. Он не описывает реальный магазин и нужен, чтобы результат можно было повторить без запросов к рабочему сайту.
Подготовьте два сохранённых файла
Первый файл — сам sitemap:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url><loc>https://shop.example/catalog/chairs</loc><lastmod>2026-10-08</lastmod></url>
  <url><loc>https://shop.example/catalog/chairs-sale</loc><lastmod>2026-10-08</lastmod></url>
  <url><loc>https://shop.example/catalog/old-chair</loc><lastmod>2026-09-12</lastmod></url>
  <url><loc>https://shop.example/catalog/draft-chair</loc><lastmod>2026-10-07</lastmod></url>
  <url><loc>https://shop.example/catalog/blue-chair?utm_source=catalog</loc><lastmod>2026-10-08</lastmod></url>
</urlset>
Второй — снимок ответов страниц. Его можно получить своим краулером или выгрузкой технического аудита. Важно сохранить конечный URL после переходов, HTTP-статус, robots и canonical в момент проверки:
source_url,http_status,final_url,robots,canonical
https://shop.example/catalog/chairs,200,https://shop.example/catalog/chairs,"index,follow",https://shop.example/catalog/chairs
https://shop.example/catalog/chairs-sale,301,https://shop.example/sale/chairs,"index,follow",https://shop.example/sale/chairs
https://shop.example/catalog/old-chair,404,https://shop.example/catalog/old-chair,,
https://shop.example/catalog/draft-chair,200,https://shop.example/catalog/draft-chair,"noindex,follow",https://shop.example/catalog/draft-chair
https://shop.example/catalog/blue-chair?utm_source=catalog,200,https://shop.example/catalog/blue-chair?utm_source=catalog,"index,follow",https://shop.example/catalog/blue-chair
Сохранённый снимок делает проверку воспроизводимой: повторный запуск на тех же двух файлах даст тот же CSV. Для рабочего приёма исправлений нужно заново снять ответы после выкладки.
Запустите проверку
Сохраните код как audit_sitemap_snapshot.py рядом с файлами sample-sitemap.xml и sample-responses.csv:
#!/usr/bin/env python3
"""Audit a saved sitemap against a saved HTTP/indexing snapshot."""

from __future__ import annotations

import argparse
import csv
from pathlib import Path
from urllib.parse import urlsplit, urlunsplit
import xml.etree.ElementTree as ET


def normalize(url: str) -> str:
    parts = urlsplit(url.strip())
    path = parts.path or "/"
    if path != "/":
        path = path.rstrip("/")
    return urlunsplit((parts.scheme.lower(), parts.netloc.lower(), path, parts.query, ""))


def read_sitemap(path: Path) -> list[dict[str, str]]:
    root = ET.parse(path).getroot()
    namespace = "{http://www.sitemaps.org/schemas/sitemap/0.9}"
    rows = []
    for item in root.findall(f"{namespace}url"):
        loc = item.findtext(f"{namespace}loc", default="").strip()
        lastmod = item.findtext(f"{namespace}lastmod", default="").strip()
        if loc:
            rows.append({"source_url": loc, "lastmod": lastmod})
    return rows


def read_snapshot(path: Path) -> dict[str, dict[str, str]]:
    with path.open(encoding="utf-8", newline="") as handle:
        return {normalize(row["source_url"]): row for row in csv.DictReader(handle)}


def classify(source_url: str, response: dict[str, str] | None) -> tuple[str, str]:
    if response is None:
        return "NO_SNAPSHOT", "Получить HTTP-ответ и сигналы страницы"

    status = int(response["http_status"])
    final_url = normalize(response["final_url"])
    source = normalize(source_url)
    canonical = normalize(response["canonical"]) if response["canonical"].strip() else ""
    robots = response["robots"].lower()

    if status in {301, 302, 303, 307, 308} or final_url != source:
        return "REDIRECT", "Заменить URL в sitemap конечным каноническим адресом"
    if status in {404, 410}:
        return "REMOVED", "Удалить URL из sitemap; проверить внутренние ссылки"
    if status < 200 or status >= 300:
        return "HTTP_ERROR", "Исправить ответ сервера и повторить проверку"
    if "noindex" in robots or "none" in {x.strip() for x in robots.split(",")}:
        return "NOINDEX", "Удалить URL из sitemap либо снять noindex по задаче страницы"
    if canonical and canonical != source:
        return "CANONICAL_MISMATCH", "Оставить в sitemap заявленный канонический URL"
    return "OK", "Оставить URL в sitemap"


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("sitemap", type=Path)
    parser.add_argument("snapshot", type=Path)
    parser.add_argument("output", type=Path)
    args = parser.parse_args()

    sitemap_rows = read_sitemap(args.sitemap)
    snapshot = read_snapshot(args.snapshot)
    output_rows = []

    for item in sitemap_rows:
        response = snapshot.get(normalize(item["source_url"]))
        result, action = classify(item["source_url"], response)
        output_rows.append({
            "source_url": item["source_url"],
            "lastmod": item["lastmod"],
            "http_status": response["http_status"] if response else "",
            "final_url": response["final_url"] if response else "",
            "robots": response["robots"] if response else "",
            "canonical": response["canonical"] if response else "",
            "result": result,
            "action": action,
        })

    fields = ["source_url", "lastmod", "http_status", "final_url", "robots", "canonical", "result", "action"]
    with args.output.open("w", encoding="utf-8", newline="") as handle:
        writer = csv.DictWriter(handle, fieldnames=fields)
        writer.writeheader()
        writer.writerows(output_rows)

    counts: dict[str, int] = {}
    for row in output_rows:
        counts[row["result"]] = counts.get(row["result"], 0) + 1
    print(" ".join(f"{key}={counts[key]}" for key in sorted(counts)))


if __name__ == "__main__":
    main()
Команда запуска:
python3 audit_sitemap_snapshot.py sample-sitemap.xml sample-responses.csv sitemap-audit.csvСкрипт печатает число адресов по каждому статусу:
CANONICAL_MISMATCH=1 NOINDEX=1 OK=1 REDIRECT=1 REMOVED=1В sitemap-audit.csv сохраняются исходный адрес, lastmod, ответ сервера, конечный URL, robots, canonical, результат и рекомендуемое действие. Такой файл удобно передать разработчику и использовать при повторной приёмке.
Как исправить каждый результат
REDIRECT
Замените исходный адрес конечным каноническим URL. Google отдельно рекомендует указывать в sitemap целевой адрес редиректа. Проверьте, что новая страница отвечает кодом 200 и ссылается canonical на себя.
REMOVED
Удалите 404 или 410 из sitemap. Затем найдите внутренние ссылки на старый URL: иначе пользователи и роботы продолжат попадать на отсутствующую страницу. Если у удалённого товара есть точная замена, решение о редиректе нужно принимать по содержанию, а не только по статусу.
NOINDEX
Сначала определите назначение страницы. Если она должна участвовать в поиске, снимите noindex и повторите проверку. Если запрет намеренный — исключите адрес из sitemap. При нескольких robots-правилах Google применяет наиболее ограничивающее.
CANONICAL_MISMATCH
Оставьте в sitemap canonical, если он выбран намеренно. В учебном примере URL с utm_source указывает на чистый адрес, поэтому в файл нужно записать чистую версию. Если canonical ошибочен, сначала исправьте страницу и лишь затем обновляйте sitemap.
Подробный разбор конфликтующих сигналов есть в материале «Canonical и noindex на одной странице: какой сигнал увидит Google».
Что проверка не доказывает
Код 200, разрешённая индексация и self-canonical делают URL подходящим для sitemap, но не обещают место в индексе. Google учитывает качество, дубли, внутренние ссылки и другие сигналы. После отправки файла контролируйте состояние страниц в отчёте Page Indexing, отфильтровав его по конкретному sitemap.
Снимок также не показывает всё поведение сайта: JavaScript может менять canonical, сервер — отвечать иначе Googlebot, а правила — зависеть от региона или авторизации. Для спорного адреса продолжите диагностику через проверку индексации и разбор причин «Почему страница сайта не индексируется?».
Как принять исправленный sitemap
Повторно выгрузите ответы после изменений и снова запустите скрипт. В итоговом CSV должны остаться только ожидаемые URL со статусом OK; исключения зафиксируйте отдельно. Затем обновите sitemap, отправьте его в Search Console и проверьте, что файл прочитан, а число найденных страниц соответствует вашему списку.
Если sitemap крупный, делите проверку на части вместе с самим файлом. Официальный предел одного sitemap — 50 МБ без сжатия или 50 000 URL; для большего набора используется индекс sitemap. Для ускорения обхода после технических изменений сначала добейтесь согласованности файла, а затем применяйте шаги из ответа «Как ускорить индексацию страниц сайта?».
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…