Перед приёмкой пагинации товарной категории проверьте две вещи: можно ли пройти по ссылкам ко всем порциям каталога и какой canonical заявлен у каждой страницы. Для маркетолога результат проверки — список конкретных URL и товаров, до которых не доходит выбранный маршрут, плюс задание разработчику с воспроизводимым примером.
Такая проверка нужна после смены шаблона категории, внедрения кнопки «Показать ещё» или бесконечной прокрутки. Удобный интерфейс для покупателя ещё требует отдельной проверки поискового маршрута. Сначала разберите одну категорию целиком, затем переносите проверку на остальные шаблоны.
Разделите маршрут и канонизацию
В рекомендациях Google по пагинации для страниц последовательности предусмотрены отдельные URL и собственные canonical. Указывать первую страницу основной для всей последовательности Google не рекомендует. Это относится к разным порциям списка: вторая страница с другими товарами не становится копией первой из-за общего заголовка категории.
Canonical — сигнал предпочтительной версии среди дублей и близких страниц, а выбор остаётся за Google. Общая инструкция WiseLab по проверке canonical помогает сравнить заявленный адрес с выбранным поисковой системой. Здесь проверяем ещё и связность всей последовательности.
Для маршрута нужны ссылки на следующие порции. Google обычно извлекает их из <a href>; действие кнопки или прокрутку нельзя считать проверенным способом обнаружения. Справка о доступных обходу ссылках допускает и ссылки, добавленные JavaScript, если в итоговом HTML есть нужная разметка. Проверяйте её в отрисованной странице.
Эти два дефекта независимы. Исправление ссылок помогает обнаружению, но не исправляет canonical. Собственный canonical не создаёт отсутствующую ссылку.
Учебный каталог: три страницы и шесть товаров
Все адреса и товары ниже вымышлены. Предполагаем стабильный порядок каталога, по два товара на страницу, доступный обход и ответы 200. В реальном магазине эти условия нужно проверить отдельно.
| URL категории | Товары | Ожидаемый canonical | Следующая порция |
|---|---|---|---|
/chairs | A, B | /chairs | /chairs?page=2 |
/chairs?page=2 | C, D | /chairs?page=2 | /chairs?page=3 |
/chairs?page=3 | E, F | /chairs?page=3 | Нет: конец списка |
В дефектном шаблоне первая страница содержит кнопку с data-next, но без ссылки. У второй и третьей страниц canonical ошибочно ведёт на /chairs. Локальный проход, начинающийся с первой страницы и следующий только по ссылкам пагинации, найдёт A и B: 2 из 6 товаров в этом маршруте.
Это не число товаров в индексе Google. C–F могут быть известны поиску из карточек, sitemap или других ссылок. Пример проверяет один путь обнаружения; он показывает зависимость каталога от дополнительных маршрутов, а не устанавливает фактическое исключение товаров из поиска.
После добавления последовательных ссылок тот же проход найдёт все шесть товаров. Отдельная проверка canonical должна подтвердить три собственных адреса. Если сделать только первый шаг, результат будет «маршрут полный, канонизация требует исправления».
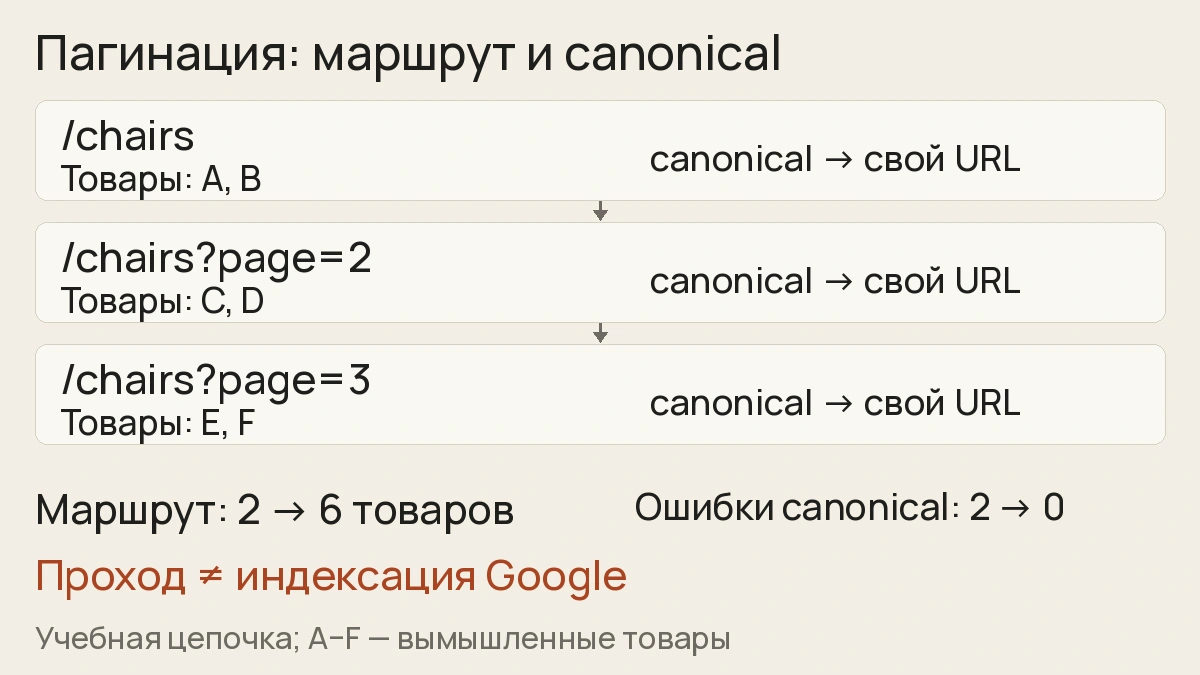
Учебная схема. Шесть найденных товаров подтверждают только полный проход по заданной цепочке, без гарантии индексации.
Как воспроизвести проверку
Для первой проверки достаточно небольшой модели на стандартном Python. В ней уже извлечённые ссылки записаны в links; атрибуты кнопки сюда не включаются. Перед переносом подхода на сайт сохраните HTML каждой порции и извлеките реальные адреса из a[href].
pages = {
    "/chairs": {"items": {"A", "B"}, "links": [],
                "canonical": "/chairs"},
    "/chairs?page=2": {"items": {"C", "D"},
                        "links": ["/chairs?page=3"],
                        "canonical": "/chairs"},
    "/chairs?page=3": {"items": {"E", "F"}, "links": [],
                        "canonical": "/chairs"},
}
def audit(data):
    todo, seen, found = ["/chairs"], set(), set()
    while todo:
        url = todo.pop()
        if url in seen:
            continue
        seen.add(url)
        found |= data[url]["items"]
        todo.extend(data[url]["links"])
    wrong = [u for u, v in data.items() if v["canonical"] != u]
    return len(found), sorted(wrong)
print(audit(pages))  # 2 товара; неверный canonical у страниц 2 и 3
pages["/chairs"]["links"] = ["/chairs?page=2"]
print(audit(pages))  # 6 товаров; canonical ещё не исправлены
for url in pages:
    pages[url]["canonical"] = url
print(audit(pages))  # 6 товаров; список неверных canonical пуст
Список ожидаемых страниц здесь известен заранее, поэтому мы проверяем canonical даже у недостижимых из первой страницы порций. Рабочий краулер без независимого списка может вовсе не узнать об их существовании. Получите ожидаемые URL и товары из согласованного каталога или экспортного задания, затем сравните с найденными.
Сохраните порядок сортировки, размер порции, фильтры, время снимка и набор ID. Во время выгрузки остатки и ассортимент могут измениться: тогда товар способен переместиться между страницами, продублироваться или исчезнуть между двумя запросами. Для приёмки используйте стабильный учебный набор либо согласованный снимок рабочего каталога.
Что передать разработчику
Попросите открывать вторую и последнюю порции по прямым URL в новой вкладке. Они должны показывать соответствующие товары без предварительного клика на первой странице. Проверьте последовательные ссылки и ссылки на карточки, конечные ответы сервера, запреты обхода и индексации, canonical в HTML и заголовках. Для динамического интерфейса сравните исходный и отрисованный HTML.
В нашем примере вторая порция может содержать:
<link rel="canonical" href="https://shop.example/chairs?page=2">
<a href="/chairs?page=3">Следующая страница</a>
Google не использует rel="next" и rel="prev" для распознавания пагинации. Номера через #page=2 также не подходят для отдельных порций. Общий title у страниц последовательности допустим; одинаковый title сам по себе не доказывает дубль. Дизайн кнопки можно сохранить, обеспечив отдельный доступный маршрут к содержимому.
Не переносите решение автоматически на сортировки и фильтры. Разная порция товаров, перестановка того же списка и самостоятельная посадочная под спрос требуют разных решений. Конфликты директив рассмотрены в разборе canonical и noindex; массовую правку шаблона сначала проверьте на выбранных сценариях.
Как принять результат
Повторите тот же проход после исправления. В учебном задании принимаем шесть ожидаемых ID, доступную последовательность из трёх URL и собственный canonical каждой порции. Строки отчёта должны содержать фактический адрес, следующий переход, найденные товары и каждое отклонение. Итоговое «ошибок нет» без исходных снимков трудно перепроверить.
Затем проверьте точные адреса в URL Inspection по инструкции WiseLab. Состояние опубликованной страницы и сохранённые данные Google могут относиться к разным моментам. Локальная приёмка не подтверждает повторный обход, выбранный Google canonical или будущие позиции; для этого нужны отдельные наблюдения в поисковом кабинете.
Следующий шаг маркетолога — выбрать одну категорию, записать ожидаемый состав и передать эту проверку как критерий приёмки релиза. Метод не требует покупки сервиса и применим к магазину в Беларуси; статья описывает рекомендации Google, без переноса их на другие поисковые системы.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…