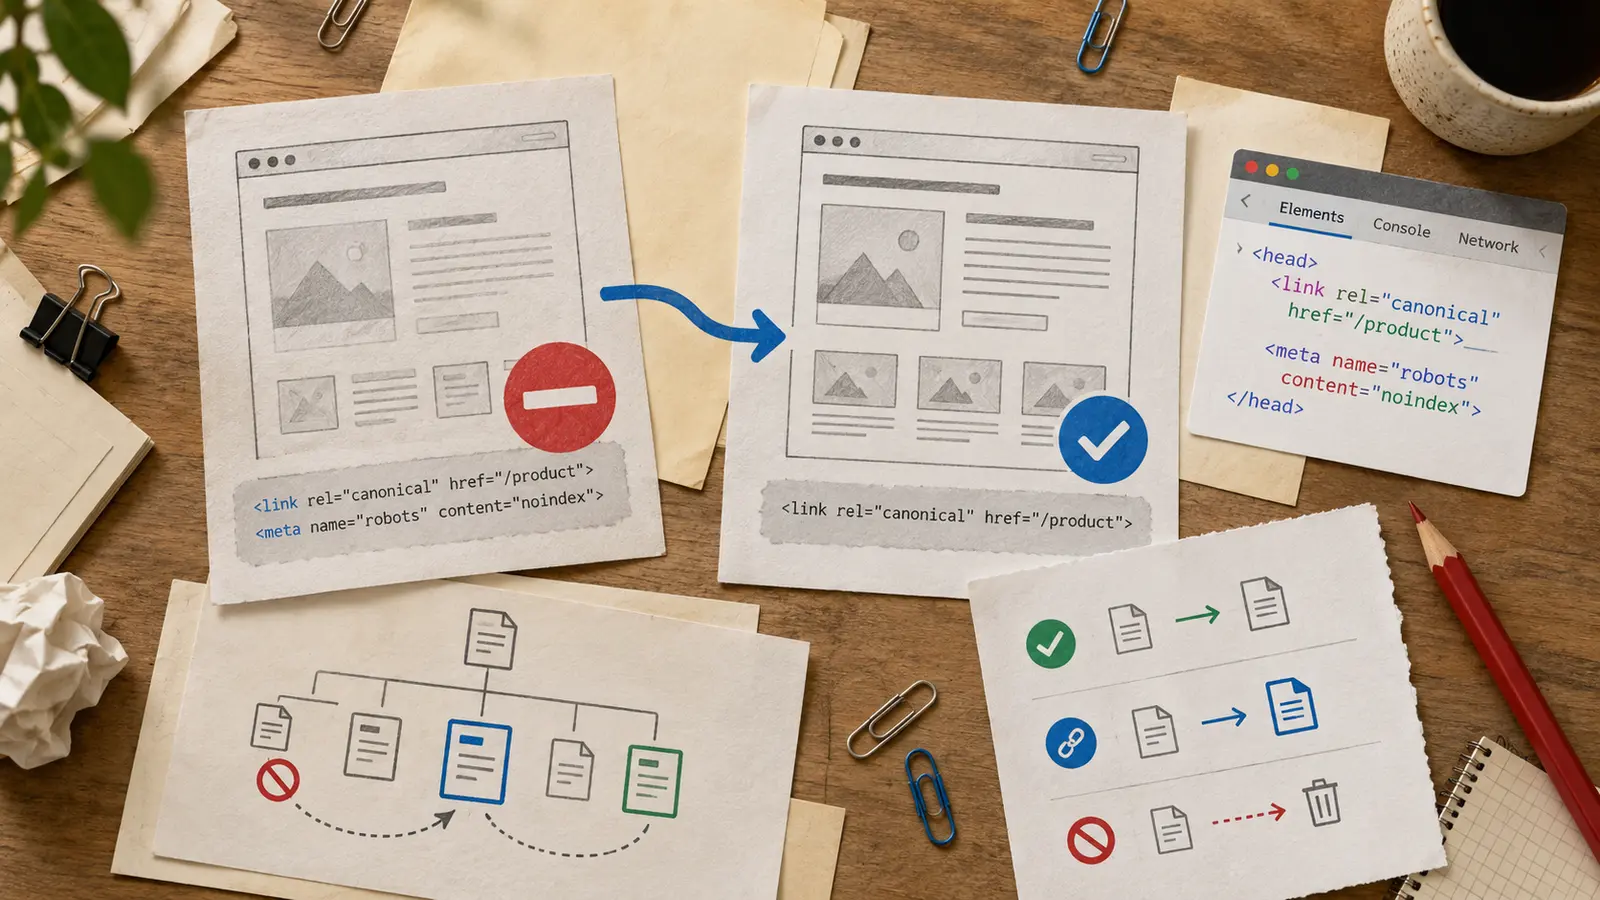
Если на странице одновременно стоят noindex и rel="canonical", сначала определите её задачу. Для индексируемой страницы нужен один набор сигналов, для дубля — другой, для полного исключения из поиска — третий. Проверка одного тега не покажет весь конфликт. noindex может прийти через HTTP-заголовок; лишний URL может остаться в sitemap и внутренних ссылках.
Соберите по точному адресу конечный HTTP-ответ, исходный HTML, X-Robots-Tag, canonical, наличие в sitemap и результат URL Inspection. После этого исправляйте один сценарий целиком.
Что означают два сигнала
rel="canonical" сообщает Google, какую версию среди дублей или почти одинаковых страниц вы предпочитаете видеть основной. Google относит HTML-аннотацию canonical к сильным сигналам, а включение в sitemap — к слабым. Эти сигналы помогают выбрать канонический URL, но окончательный выбор остаётся за поисковой системой.
noindex запрещает показывать конкретную страницу в результатах Google после того, как робот её обойдёт и прочитает правило. Его можно передать в <meta name="robots"> или в HTTP-заголовке X-Robots-Tag.
Google прямо не рекомендует использовать noindex, чтобы повлиять на выбор канонической страницы внутри сайта: правило полностью исключает URL из поиска, а canonical предназначен для объединения дублей. Поэтому сочетание двух сигналов требует проверки намерения владельца страницы.
Проверьте все источники сигнала
1. Получите конечный HTTP-ответ
Проверьте код после всех редиректов и заголовки ответа:
curl -I -L https://example.com/pageИщите X-Robots-Tag, Link: <...>; rel="canonical", конечный статус и конечный URL. CDN, прокси или веб-сервер могут добавить noindex, которого нет в шаблоне CMS.
2. Прочитайте исходный HTML
Внутри <head> найдите все варианты:
<meta name="robots" content="noindex, follow">
<meta name="googlebot" content="noindex">
<link rel="canonical" href="https://example.com/preferred-page">
Несколько robots-правил не отменяют друг друга. Google применяет совокупность ограничений; отдельный index не нейтрализует найденный noindex.
3. Сверьте sitemap и внутренние ссылки
Google рекомендует включать в sitemap URL, которые вы хотите видеть в поиске, и использовать канонические адреса. Если noindex-страница находится в sitemap, а меню и карточки ведут именно на неё, сайт отправляет разные сигналы о желаемом результате.
4. Сравните с данными Google
В URL Inspection смотрите две версии состояния:
- сохранённые данные индекса: что Google увидел при последнем обходе;
- проверку опубликованной страницы: что сервер возвращает сейчас.
Сверьте пользовательский canonical, выбранный Google canonical, доступность обхода и обнаруженный noindex. Изменение в CMS не означает, что поисковик уже получил новую версию.
Учебный пример: фильтр каталога получил три разных указания
Страница https://shop.example/catalog/chairs?color=blue возвращает 200 OK. В HTML стоят noindex и canonical на /catalog/chairs, а sitemap содержит оба адреса.
| Источник | Значение | Что означает |
|---|---|---|
| HTTP | 200 | страницу можно получить |
| meta robots | noindex, follow | параметрический URL не должен появляться в поиске |
| canonical | /catalog/chairs | основной версией заявлен общий каталог кресел |
| sitemap | оба URL | обе страницы предлагаются как желательные для поиска |
Такой набор не объясняет цель однозначно. Если страница с синими креслами — полезная посадочная, ей нужен собственный индексируемый URL и согласованный canonical. Если это дубль общего каталога, оставьте страницу доступной роботу, уберите noindex, укажите canonical на основной URL и исключите дубль из sitemap. Если параметрический URL должен исчезнуть из поиска, сохраните доступный роботу noindex, удалите URL из sitemap и внутренних ссылок.
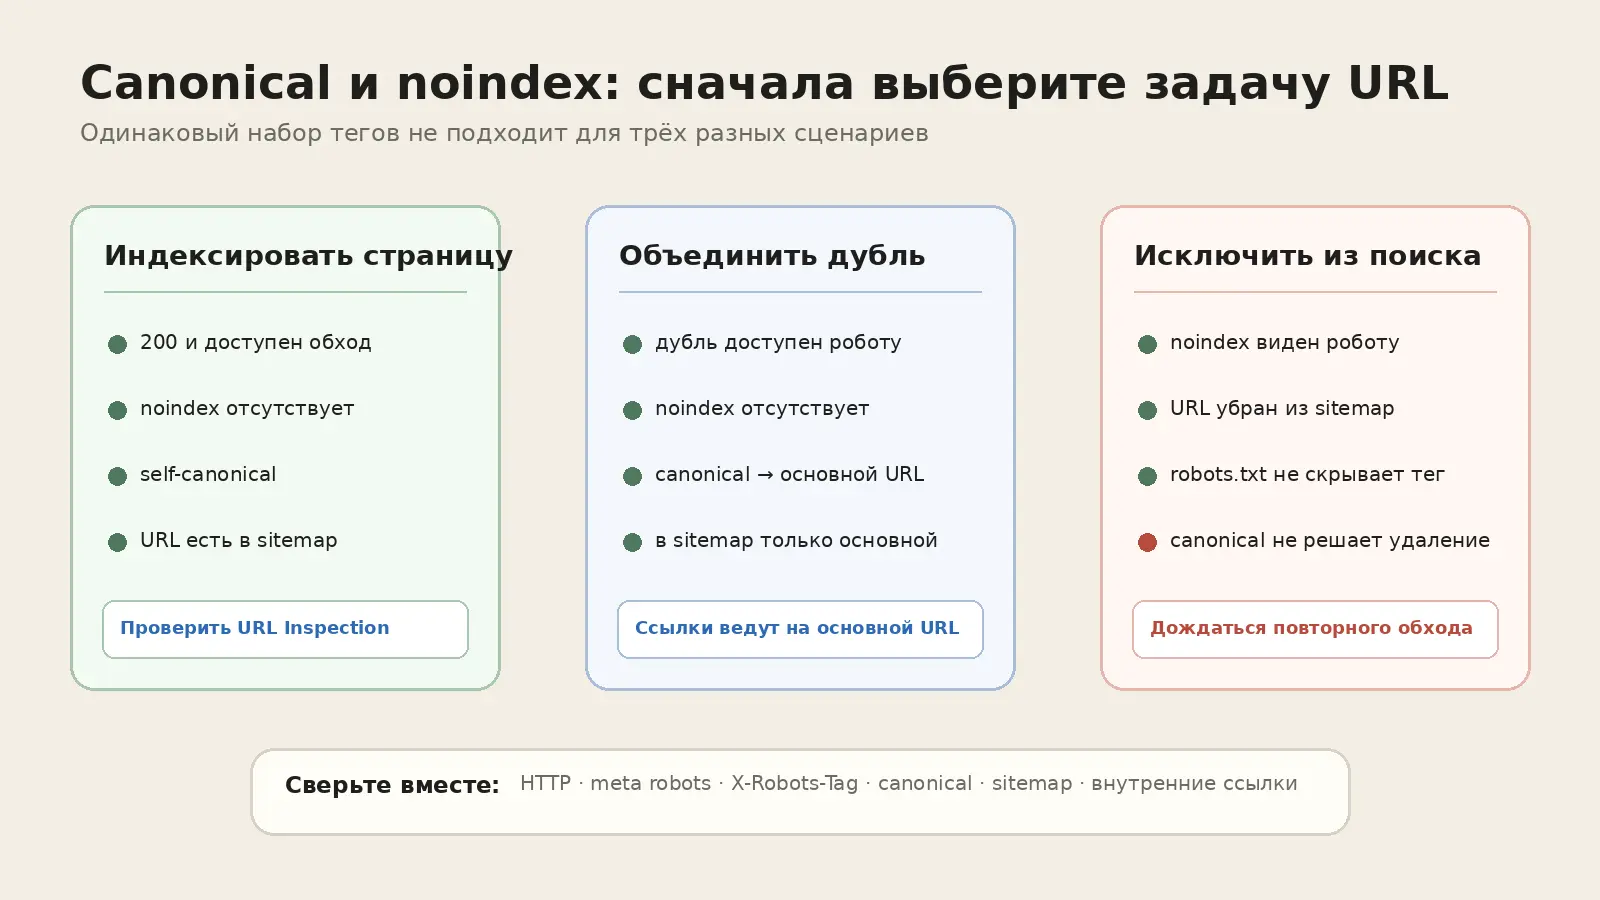
Набор сигналов выбирают по задаче URL. Проверка охватывает HTTP, HTML, sitemap и внутренние ссылки.
Выберите один сценарий исправления
Страница должна индексироваться
Удалите noindex из HTML и HTTP-заголовков. Оставьте self-canonical либо канонический адрес, соответствующий фактической основной версии. Добавьте этот URL в sitemap и используйте его во внутренних ссылках. После публикации проверьте живую страницу и запросите повторный обход.
Страница является дублем
Оставьте дубль доступным для обхода и укажите canonical на предпочтительную версию. Уберите дубль из sitemap, а внутренние ссылки направьте на основной URL. Google может выбрать другую каноническую страницу, поэтому результат сверяют в URL Inspection.
Если дубль больше не нужен пользователям, постоянный редирект на основную версию даёт более сильный сигнал, чем canonical. Перед редиректом проверьте, что страницы действительно равнозначны по задаче.
Страница должна исчезнуть из поиска
Передайте noindex через meta robots или X-Robots-Tag, удалите URL из sitemap и перестаньте использовать его как индексируемую посадочную. Не блокируйте адрес в robots.txt до обработки noindex: Google должен обойти страницу, чтобы увидеть правило.
Для удалённого навсегда содержимого используйте подходящий HTTP-статус, например 404 или 410. Для приватных данных требуется авторизация; поисковые директивы не являются защитой доступа.
Запустите воспроизводимую проверку
В комплекте есть учебный HTML, сохранённые заголовки, sitemap и скрипт на стандартной библиотеке Python:
python3 inspect_index_signals.py \
  'https://shop.example/catalog/chairs?color=blue' \
  response-headers.txt page-source.html sample-sitemap.xml \
  signal-audit.csv
Проверка возвращает:
status=200 noindex=true canonical=https://shop.example/catalog/chairs in_sitemap=true conclusion=NOINDEX_WITH_CANONICAL_AND_SITEMAPКомплект добавлен 21 октября 2026 года. Это учебные, синтетические HTML, HTTP-заголовки и sitemap, а не снимок реального сайта. В архиве — полный скрипт, исходные файлы, README и CSV, полученный опубликованной командой. Скачать комплект.
CSV фиксирует каждый сигнал, статус и следующее действие. Для рабочего сайта сохраняйте фактический ответ после редиректов и полученный HTML с датой проверки. JavaScript, персонализация, география CDN и разные user-agent могут менять результат, поэтому при споре сравнивайте обычный запрос с тем, что показывает URL Inspection.
Как принять исправление
Исправление готово, когда один сценарий читается одинаково во всех источниках:
- конечный HTTP-статус соответствует задаче страницы;
- в meta robots и
X-Robots-Tagнет противоречащих ограничений; - canonical ведёт на подтверждённую основную версию;
- sitemap содержит только URL, предназначенные для поиска;
- внутренние ссылки поддерживают тот же адрес;
- опубликованная проверка Google видит новую конфигурацию.
Для общей диагностики начните с ответа «Почему Google не индексирует сайт». Значение canonical и сравнение с выбранной Google версией разобраны отдельно в инструкции «Как проверить canonical». После исправления проверьте точный адрес через URL Inspection.
Ограничения проверки
Локальная проверка подтверждает сигналы в сохранённом ответе. Она не доказывает, какую версию уже обработал Google, и не гарантирует выбор указанного canonical. Search Console может показывать состояние предыдущего обхода; итог проверяют после повторного сканирования.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…