В официальной справке Google четко сказано, что канонический url и его копия могут находиться на разных доменах. Там же упоминается копирование контента на другие сайты как хорошая причина использовать rel=»canonical». А в этом старом видео Мэтт Каттс объясняет, что canonical практически такой же сильный сигнал, как и 301 редирект и обычно Google следует рекомендациям.
Когда требуется объединить похожие, но не идентичные страницы, склейка далеко не всегда происходит гладко. При републикации контента страницы вряд ли будут идентичными. Поэтому эффективность кросс-доменного canonical по умолчанию под вопросом. Достаточно ли для Google совпадения только основной части контента?
Вопрос не только интересен сам по себе, но и важен для практики. Например, в англоязычном Интернете довольно массово копируют контент на Medium (я сам так делал). Платформа ставит canonical на оригинал. Спасибо ей за это: у нас есть удобный объект для изучения.
Методика и общие результаты
В октябре прошлого года я сделал следующее:
- Спарсил 660 000 страниц с Medium.com.
- Отобрал из них те, что имели external canonical — их оказалось 6132.
- Убрал дублиткаты и страницы с h1 короче 20 символов — осталось 4656 url.
- Для каждого h1 спарсил ТОП-10 Google.
- Сравнил позицию для оригинала и копии.
Получилось вот так:
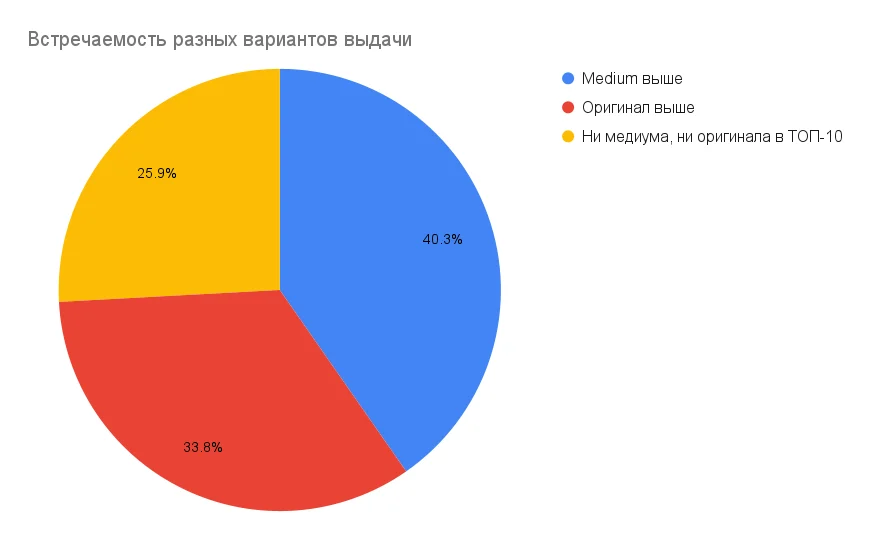
Какой можно сделать вывод? Конечно, эти результаты в вакууме мало о чем говорят. Тут только один срез, нет ситуации в динамике. Никак не проконтролировано сходство контента в источнике и в копии. Не проверена на доступность контента в оригинале и так далее и тому подобное. Чтобы сделать валидное исследование, нужно приложить еще массу усилий.
Однако очевидно, что если бы canonical отрабатывал быстро и четко, стоило ожидать другую картину. Выборка достаточно велика, чтобы сгладить случайности вроде физического исчезновения оригинала. Похоже, что canonical здесь работает через раз.
Об этом же говорит тот факт, что только в 692 случаях Medium-а нет в выдаче совсем.
Я не стал углублять исследование, чтобы отсечь все случайности. Сейчас меня больше интересует собственная насмотренность, чем академически точная истина. Просто подождал несколько месяцев и вручную изучил несколько десятков страниц. Потом снова подождал и еще раз посмотрел. Давайте посмотрим снова.
5 типичных примеров
Набрал из выборки за 10 минут. Похоже, что если Medium лучше ранжировался в прошлом году, то он обычно сохраняет лидерство и сейчас.
Источника нет в индексе, даже в в расширенных результатах. По кускам фразы ищется Medium.
Источник в индексе и, согласно Ahrefs, ранжируетра по 168 ключевым фразам, но по «15 Things I’ve Learned from Living in New York City» выводится Medium. Что неудивительно, так как структура заголовков в двух версиях текста разная.
Оба в индексе, ранжируются по нескольким ключам, с небольшим преимуществом оригинала.
Оба в индексе, некоторое время назад оба имели ключи по Ahrefs, сейчас у Medium они исчезли.
Медиум ранжируется по 300 запросам, оригинал по 20-30.
Конечно, есть много примеров, где canonical отрабатывает полностью так, как должен. Немало кейсов, где страница на сайте с совсем слабым ссылочным побеждает копию на мощном Medim. Однако в целом, приступая к изучению, я ожидал, что случаи, где длительное время доминирует копия, будут более редкими. А влияние canonical, соответственно, более весомым.
✍️ Междоменный canonical работает далеко не всегда. Это более слабый сигнал, чем может показаться при чтении справки Google.
Источник публикации: AlexeyTrudov.com
Что думаете?
Загружаем комментарии…