Фид может открываться в браузере и всё равно не разбираться рекламной системой: браузер показывает текст после собственной попытки определить кодировку, а XML-парсер обязан сопоставить реальные байты с декларацией и правилами XML. Чтобы не лечить «кракозябры» заменой символов, проверьте три слоя по порядку: кодировку, допустимость символов и структуру документа.
Сначала зафиксируйте точную версию
Скачайте проблемный ответ и сохраните его как файл. Запишите URL, время получения, размер и, если проверка связана с обновлением, контрольную сумму. По одному адресу генератор может отдать уже другую версию; порядок такой же, как в разборе обновления YML-фида по URL.
Не копируйте XML из окна браузера в редактор перед диагностикой. При вставке программа может сама преобразовать байты в Unicode, удалить BOM или заменить непонятные символы. Вы получите новый файл и потеряете доказательство исходной ошибки.
Разделите три вида сбоя
1. Реальные байты не совпадают с декларацией
В начале YML обычно стоит декларация <?xml version="1.0" encoding="UTF-8"?>. Примеры Яндекс Директа также используют UTF-8. Декларация должна описывать фактическое кодирование всего документа, а не желаемый формат.
По спецификации XML процессоры обязаны поддерживать UTF-8 и UTF-16. Если декларация говорит UTF-8, а кириллица записана байтами Windows-1251, это фатальная ошибка: последовательность байтов недопустима для заявленной кодировки. Простая смена надписи UTF-8 на windows-1251 может заставить конкретный парсер прочитать файл, но устойчивее исправить генератор и заново выгрузить весь документ в UTF-8.
2. Текст декодируется, но содержит запрещённый символ
XML 1.0 разрешает табуляцию, перевод строки и возврат каретки, но запрещает большую часть управляющих символов ниже U+0020. Например, U+0001 может незаметно попасть в название товара из ERP или таблицы: UTF-8 остаётся корректным, однако XML-парсер остановится на invalid token.
Удалять все «невидимые символы» регулярным выражением опасно: можно потерять допустимые переводы строк и изменить описание товара. Сначала выведите кодовую точку и позицию, найдите исходное поле, затем очистите значение в источнике или в одном контролируемом шаге экспорта.
3. Кодировка и символы верны, но сломана структура
Тогда причина находится на уровне XML: незакрытый тег, необработанный &, повреждённый атрибут, два корневых элемента. В этом случае декодирование пройдёт, а парсер вернёт строку и столбец синтаксической ошибки. После исправления структуры продолжите обычную проверку ошибок и предупреждений YML.
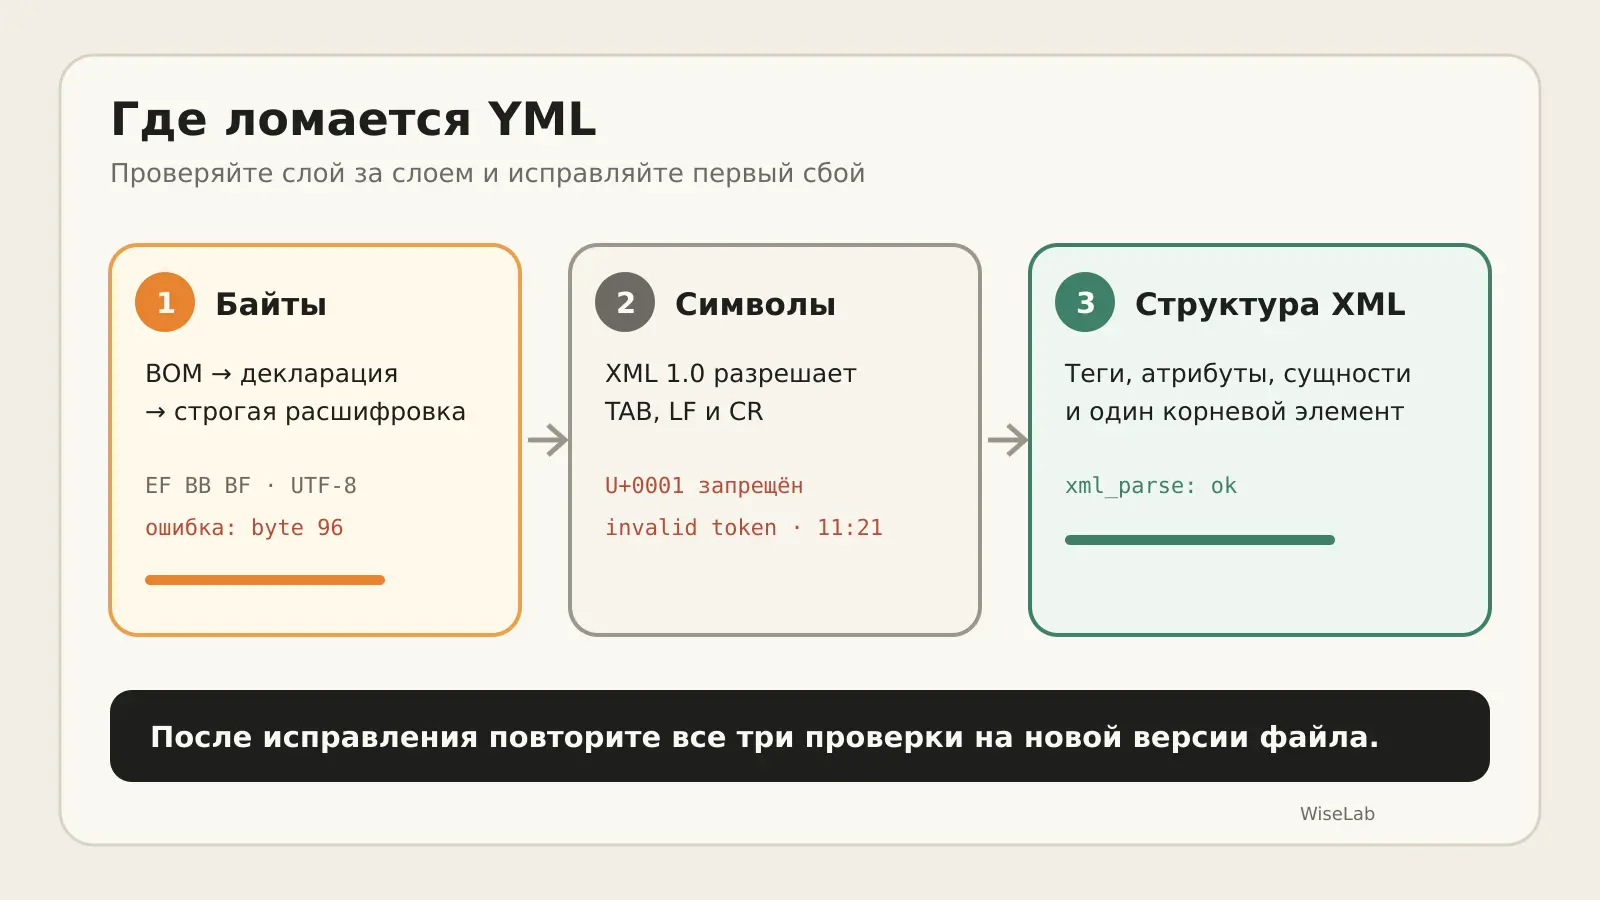
Проверка идёт снизу вверх по зависимости: парсить структуру имеет смысл только после корректного чтения байтов и символов.
Воспроизводимый тест на трёх файлах
В учебном комплекте один и тот же товар сохранён в трёх вариантах. Первый — корректный UTF-8. Во втором декларация осталась UTF-8, но файл записан как Windows-1251. В третьем UTF-8 корректен, однако в название кресла вставлен U+0001.
| Файл | Строгое декодирование | Проверка XML | Диагноз |
|---|---|---|---|
sample-good.yml | проходит | проходит | базовая версия корректна |
sample-declared-utf8-actual-cp1251.yml | ошибка на байте 96 | не запускается | байты не соответствуют декларации |
sample-illegal-control.yml | проходит | строка 11, столбец 21 | запрещённый XML 1.0 символ U+0001 |
Сохраните следующий фрагмент как audit_yml_encoding.py рядом с фидом. Он проверяет локальный файл без сторонних библиотек:
import re
import sys
import xml.etree.ElementTree as ET
from pathlib import Path

data = Path(sys.argv[1]).read_bytes()
match = re.search(br'<\?xml\s+[^>]*encoding=["\']([^"\']+)["\']', data[:512], re.I)
encoding = match.group(1).decode('ascii') if match else 'utf-8'

try:
    text = data.decode(encoding)
    print(f'decode: ok ({encoding})')
except UnicodeDecodeError as error:
    print(f'decode: byte {error.start}, {error.reason}')
    raise SystemExit(1)

allowed = lambda cp: cp in (9, 10, 13) or 0x20 <= cp <= 0xD7FF or 0xE000 <= cp <= 0xFFFD or 0x10000 <= cp <= 0x10FFFF
bad = [(i, f'U+{ord(char):04X}') for i, char in enumerate(text) if not allowed(ord(char))]
print('illegal XML 1.0:', bad[:20])

try:
    ET.fromstring(data)
    print('xml_parse: ok')
except ET.ParseError as error:
    print(f'xml_parse: {error}; position={error.position}')
Запустите его так:
python audit_yml_encoding.py feed.ymlВ редакционном комплекте к статье есть расширенная версия: она также принимает URL, сохраняет конечный адрес и Content-Type, определяет BOM, пишет JSON-отчёт и ограничивает сетевую загрузку 50 МиБ. Для публичной проверки передавайте только URL без секретного токена; приватный фид сначала сохраните локально.
Python сообщает ParseError с позицией строки и столбца. Это координата парсера, а не готовый диагноз: ошибка может начаться раньше, например с незакрытого тега. Поэтому приложите к задаче несколько строк до и после позиции, но не пересылайте весь коммерческий каталог в публичный чат.
Как исправить без потери данных
Если не совпали байты и декларация, найдите кодировку на выходе генератора. Перекодируйте из известной исходной кодировки в UTF-8 один раз и проверьте, что названия, URL и идентификаторы не изменились. Нельзя надёжно «угадать» произвольную кодировку только по одному короткому фрагменту.
Если найден запрещённый символ, вернитесь к записи товара в CMS, ERP или исходной таблице. Зафиксируйте offer id, поле, кодовую точку и источник. После очистки соберите фид заново и сравните количество офферов, уникальные ID и контрольные товары. Чек-лист приёмки исправленного товарного фида помогает не принять исчезновение товаров за успешное исправление.
Если локальный XML-парсер проходит, это подтверждает только читаемость документа. Дальше откройте анализатор фидов WiseLab, выберите правила Яндекс Директа и проверьте справочники, обязательные поля, цены, ссылки и изображения. Окончательное решение о приёме товаров остаётся за рекламной системой после её собственной загрузки.
Что передать разработчику
Хорошая задача содержит точный файл или URL и время получения, размер и контрольную сумму, заявленную кодировку, первый сбойный байт либо кодовую точку, строку и столбец XML-ошибки, а также один offer id, на котором проблема воспроизводится. Критерий готовности: строгая расшифровка проходит, запрещённых XML 1.0 символов нет, документ разбирается целиком, ассортимент не сократился необъяснимо, а новая версия обработана площадкой.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…