Если одна кампания встречается в отчёте как google, Google и google , её визиты и лиды распадутся на несколько строк. Соберите рядом с исходными полями нормализованные, а затем группируйте данные по ним. Так вы объедините технические варианты записи и сможете проверить, что строки и суммы не изменились.
Сначала сохраните сырой слой
Не исправляйте UTM прямо в единственной выгрузке. Оставьте utm_source_raw, utm_medium_raw и utm_campaign_raw, а результат записывайте в новые поля с суффиксом _norm.
Это нужно по двум причинам. Во-первых, можно объяснить, почему конкретная строка попала в группу. Во-вторых, ошибочное правило легко откатить без повторной выгрузки из аналитики.
Яндекс Метрика различает регистр UTM-значений: Vkontakte и vkontakte влияют на отображение данных в отчётах как разные записи. Метрика получает сведения о метках из первого просмотра страницы в визите и строит для UTM отдельные отчёты. Подробности есть в документации Яндекс Метрики.
Разделите техническую очистку и смысловое объединение
К технической очистке относятся операции, которые не меняют смысл значения:
- убрать пробелы в начале и конце;
- привести регистр по правилу команды — например, к нижнему для
utm_sourceиutm_medium; - обозначить пустые значения единым служебным маркером, не смешивая их с реальной строкой
none; - сохранить журнал правила и дату применения.
Замена fb на facebook уже требует словаря соответствий. То же относится к paid_social и cpc, spring-sale и spring_sale: похожее написание ещё не доказывает одинаковый смысл. Такие пары подтверждает владелец разметки, после чего правило попадает в отдельную таблицу.
Если исходником служит полный URL, сначала разбирайте его стандартным URL-парсером. Не заменяйте %, + и амперсанды вручную: они участвуют в кодировании строки запроса. В Python для этого есть urllib.parse; правила процентного кодирования описаны в RFC 3986. Если аналитическая система уже выгрузила UTM в отдельных колонках, повторно декодировать их не нужно.
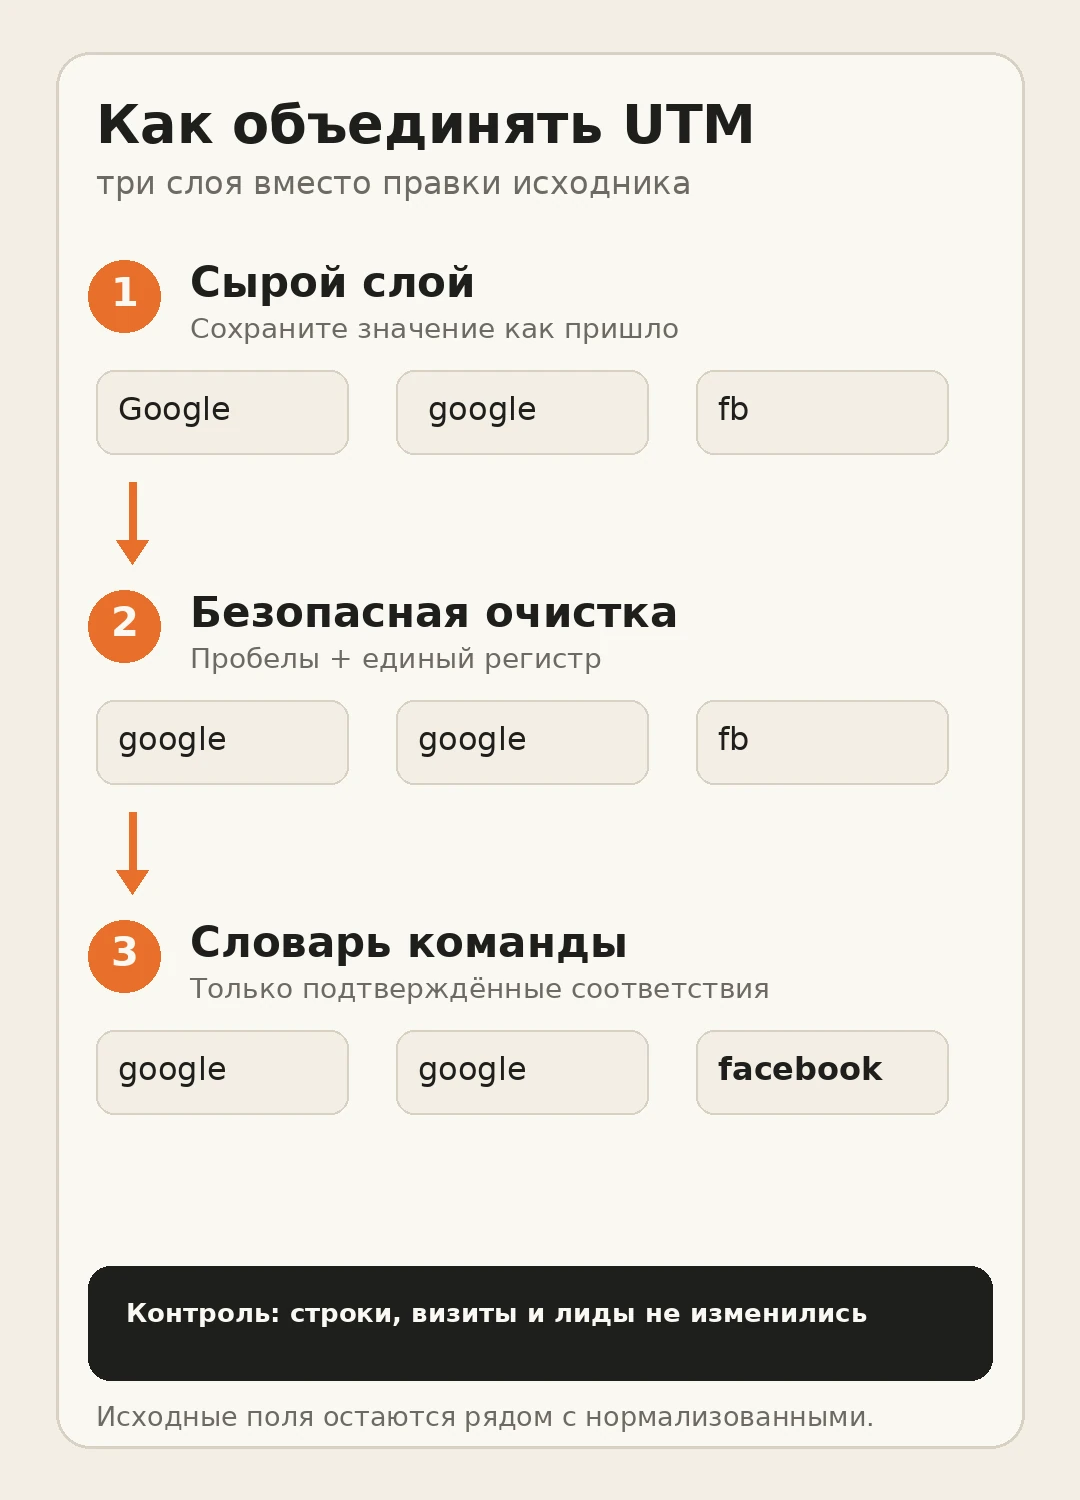
Автоматически очищайте только форму записи; смысловые соответствия храните в отдельном словаре.
Проверьте на маленьком примере
Учебная выгрузка содержит шесть строк:
| row_id | utm_source | utm_medium | utm_campaign | Визиты | Лиды |
|---|---|---|---|---|---|
| R01 | google | cpc | spring_sale | 120 | 8 |
| R02 | Google | CPC | spring_sale | 70 | 4 |
| R03 | google | cpc | spring_sale | 30 | 2 |
| R04 | fb | paid_social | spring_sale | 55 | 5 |
| R05 | facebook | paid_social | spring_sale | 45 | 3 |
| R06 | telegram | messenger | spring_sale | 40 | 1 |
До обработки в таблице 360 визитов и 23 лида. После удаления внешних пробелов и приведения регистра три строки Google объединяются: 220 визитов и 14 лидов. Значения fb и facebook остаются раздельными, пока в словаре команды не появится подтверждённое соответствие fb → facebook; после него группа Facebook содержит 100 визитов и 8 лидов.
Минимальная логика на Python выглядит так:
def safe_text(value: str) -> str:
    return value.strip().casefold()

source_safe = safe_text(row["utm_source"])
source_norm = source_map.get(source_safe, source_safe)
В рабочем комплекте скрипт сохраняет сырой и нормализованный варианты, собирает итоговую таблицу и останавливается, если число строк либо суммы визитов и лидов изменились.
Примите результат по четырём проверкам
1. Число исходных строк не изменилось
Нормализация добавляет поля, но не удаляет наблюдения. Если строки нужно объединить для отчёта, агрегацию делайте отдельным шагом и сохраняйте исходную таблицу.
2. Аддитивные показатели совпали
Суммы визитов, лидов, расходов и выручки до и после подготовки должны совпадать. Ставки и проценты не складывайте: конверсию пересчитывают как лиды / визиты уже для новой группы.
3. Каждое смысловое правило объяснимо
Для словаря достаточно четырёх колонок: поле, исходное значение, нормализованное значение, основание. Если основания нет, оставьте варианты раздельными и вынесите их в список на проверку.
4. Новые значения не проходят незаметно
На каждом обновлении формируйте перечень UTM, которых ещё нет в словаре. Это помогает увидеть опечатку или новое размещение до того, как оно попадёт в ежемесячный отчёт.
Что делать дальше
Если проблема начинается раньше — метки теряются после редиректа или визит не находится в системе, пройдите короткую проверку UTM в Яндекс Метрике. Для новых ссылок заведите единый словарь и правила именования по гайду WiseLab по UTM-разметке. После нормализации пересчитайте показатели по объединённым группам и сравнивайте их только при одинаковом определении визита, лида и периода.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…