ИИ может вернуть аккуратную сводку, в которой совпадает общий расход, хотя одна строка исходного отчёта потеряна, а другая учтена дважды. Перед решением о бюджете проверьте состав строк, контрольные суммы и заново рассчитайте относительные метрики.
Начните с ключа строки
Добавьте в исходный файл row_id: уникальный идентификатор каждой строки. Если отчёт выгружен по дням, кампаниям и устройствам, ключ можно собрать из этих полей, но сначала убедитесь, что такая комбинация действительно уникальна.
Попросите ИИ вернуть вместе со сводкой список использованных row_id. Тогда полнота проверяется как обычное сравнение двух наборов: какие ключи пропали, какие появились и какие повторились.
Для таблиц лучше сохранять один объект в одной строке и давать столбцам понятные названия. Такой формат рекомендует и справка OpenAI по анализу данных. Там же советуют просматривать созданный код, результаты и допущения перед тем, как опираться на вывод.
Учебный пример: расход совпал, строки — нет
В исходном отчёте шесть строк:
| row_id | Кампания | Устройство | Показы | Клики | Расход, BYN | Лиды |
|---|---|---|---|---|---|---|
| R01 | Поиск | mobile | 1 000 | 80 | 120 | 6 |
| R02 | Поиск | desktop | 800 | 56 | 84 | 4 |
| R03 | Ремаркетинг | mobile | 500 | 45 | 72 | 5 |
| R04 | Ремаркетинг | desktop | 400 | 28 | 49 | 2 |
| R05 | Поиск | mobile | 900 | 63 | 110 | 5 |
| R06 | Поиск | desktop | 700 | 42 | 84 | 3 |
Предположим, в расчёт попали R01, R03, R04, R05, R06, R06: строка R02 потерялась, а R06 продублировалась. У обеих строк расход равен 84 BYN, поэтому общий расход остался прежним — 519 BYN.
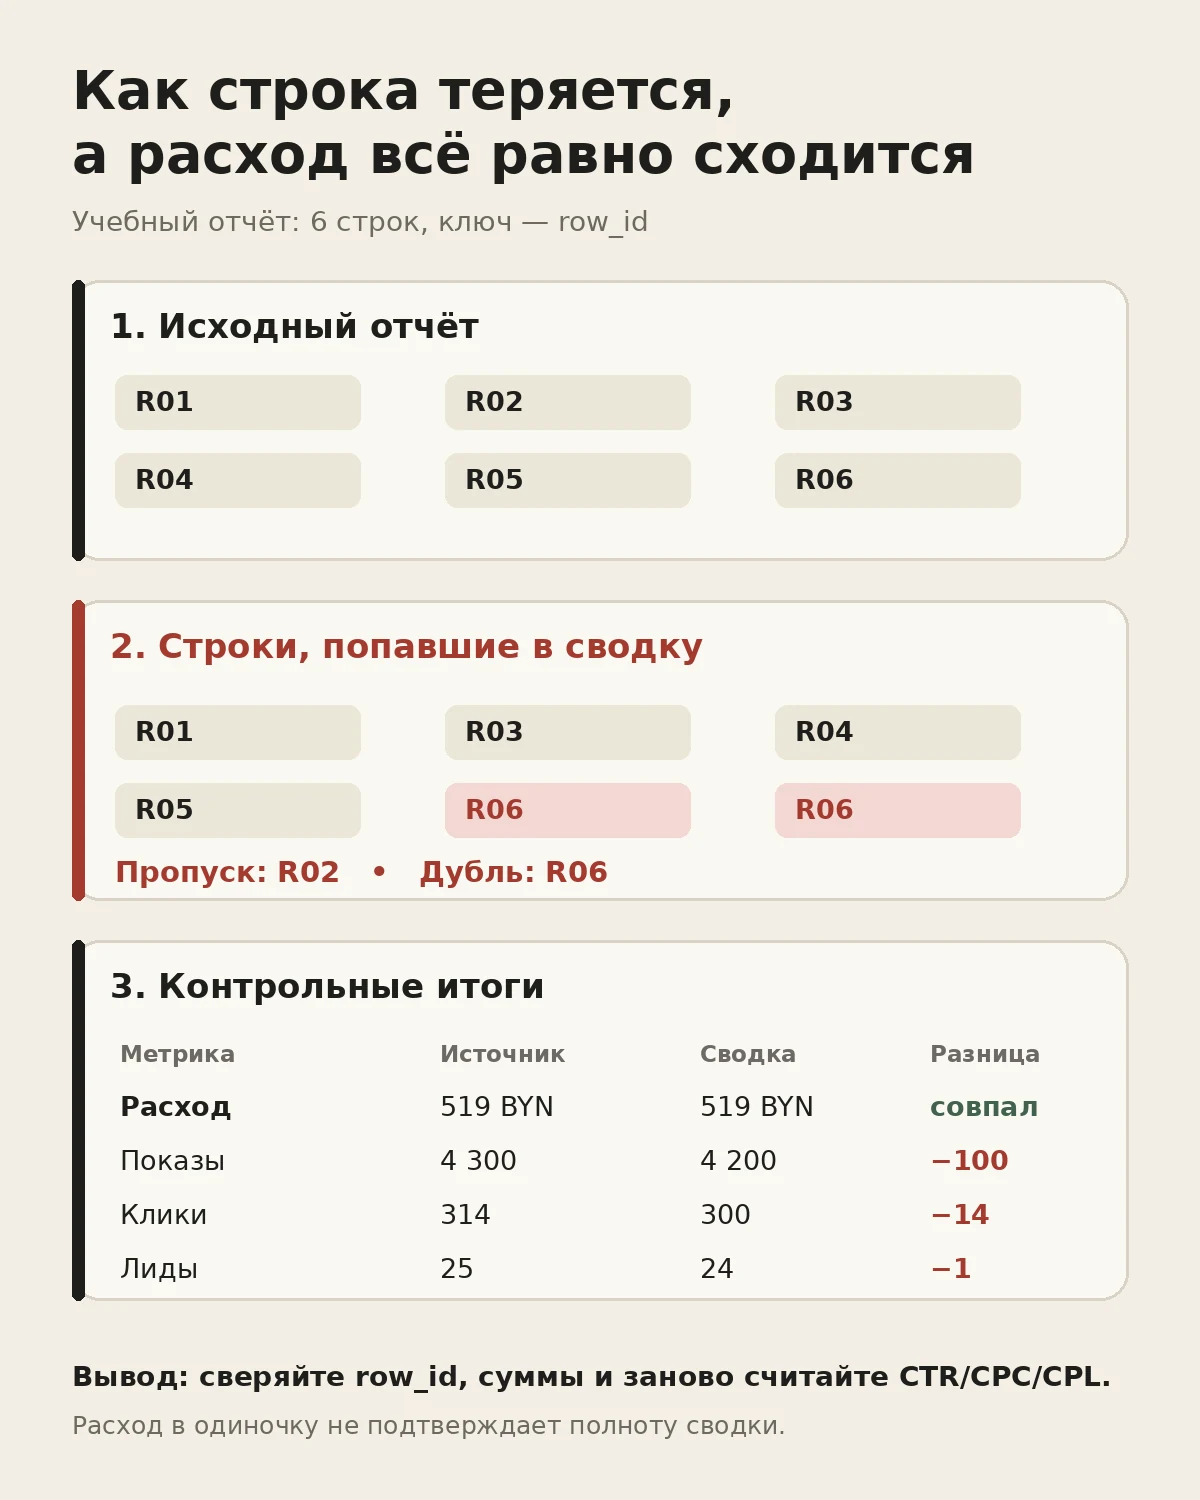
Одинаковый расход маскирует ошибку состава строк. Сверка ключей сразу показывает пропуск и дубль.
| Метрика | Исходный отчёт | Ошибочная сводка | Разница |
|---|---|---|---|
| Расход, BYN | 519 | 519 | 0 |
| Показы | 4 300 | 4 200 | −100 |
| Клики | 314 | 300 | −14 |
| Лиды | 25 | 24 | −1 |
Один контрольный итог дал ложное чувство точности. Проверка остальных аддитивных метрик нашла расхождение, а сравнение row_id указало его причину.
Пересчитайте CTR, CPC и CPL из итогов
Относительные показатели нельзя проверять простым средним по строкам. Сначала сложите числители и знаменатели, затем примените формулу к итогам:
CTR = клики / показы × 100%;CPC = расход / клики;CPL = расход / лиды.
Google Ads определяет CTR как отношение кликов к показам, а средний CPC — как общий расход на клики, делённый на число кликов. В учебном исходнике получаются CTR 7,30%, CPC 1,65 BYN и CPL 20,76 BYN. В ошибочной сводке — 7,14%, 1,73 BYN и 21,63 BYN.
Разница невелика и может остаться незамеченной в рабочем отчёте. При большем объёме данных такая ошибка способна поменять рейтинг кампаний и решение о перераспределении бюджета.
Проверьте сводку в пять шагов
1. Зафиксируйте единицу строки
Запишите, что означает одна строка: день × кампания × устройство, заказ, рекламное объявление или поисковый запрос. Без этого нельзя понять, где допустимо суммирование и какой ключ должен быть уникальным.
2. Сравните количество и ключи
Проверьте число строк до обработки и после отбора. Затем найдите пропущенные, лишние и повторяющиеся row_id. Совпадение количества строк само по себе недостаточно: как в примере, один пропуск и один дубль компенсируют друг друга.
3. Сверьте контрольные суммы
Сравните показы, клики, расход и лиды по всему файлу. Добавьте разрезы, важные для решения: дата, кампания, устройство, регион. Общий итог может совпасть, когда ошибка находится внутри группы.
4. Рассчитайте относительные метрики заново
Используйте итоговые клики, показы, расход и лиды. Не переносите в сводку среднее значение столбца CTR или CPC: строки могут иметь разный вес.
5. Сохраните отчёт об исключениях
Вместе с итоговой таблицей сохраните список исключённых строк, дубликатов, неизвестных ключей и применённых фильтров. Если таких строк нет, отчёт должен быть пустым, а не отсутствовать. Это помогает отличить проверенный нулевой результат от пропущенной проверки.
Минимальный автоматический тест
Проверку можно выполнить коротким скриптом. Он сравнивает ключи и суммы, а затем рассчитывает метрики из итогов:
from collections import Counter

source_ids = ["R01", "R02", "R03", "R04", "R05", "R06"]
used_ids = ["R01", "R03", "R04", "R05", "R06", "R06"]

missing = sorted(set(source_ids) - set(used_ids))
duplicates = sorted(k for k, n in Counter(used_ids).items() if n > 1)

assert not missing, f"Пропущены строки: {missing}"
assert not duplicates, f"Дубли строк: {duplicates}"
В полном варианте тест должен дополнительно сверять суммы по аддитивным метрикам и останавливать приёмку при любом необъяснённом расхождении. Для файла без готового row_id сначала создайте составной ключ и отдельно проверьте его уникальность.
Что запросить у ИИ вместе со сводкой
Полезный результат содержит четыре части:
- таблицу с ответом на бизнес-вопрос;
- список использованных и исключённых
row_id; - контрольные итоги до и после обработки;
- формулы, код и допущения.
Такой комплект позволяет повторить расчёт без догадок. NIST в профиле рисков генеративного ИИ рекомендует проверять выходные материалы на валидность и надёжность, а также документировать проверки; для рекламного отчёта это превращается в обычную сверку строк, сумм и формул.
Если вы только выбираете рабочий способ анализа, начните с обзора ИИ-инструментов для задач маркетинга. Общую методику приёмки ответа продолжает материал «Как оценивать качество результата ИИ»: там проверка разделена на факты, расчёты и выводы.
Сводку можно принимать, когда набор ключей совпал с источником, дубли отсутствуют, контрольные суммы сошлись, относительные метрики пересчитаны из итогов, а все исключения объяснены. До этого используйте результат как черновик анализа.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…