ИИ может за несколько минут разметить сотни поисковых запросов, но одна ошибочная минус-фраза способна убрать показы по полезному спросу. Перед загрузкой результата в рекламный кабинет проверьте разметку на контрольной выборке: сравните решения модели с ручной разметкой, отдельно посчитайте опасные исключения и оставьте спорные случаи человеку.
Ниже — воспроизводимый пример для условного магазина новых офисных кресел. Все запросы, клики и расходы в примере учебные; они показывают метод расчёта и не описывают реальную кампанию.
Сначала определите действие, которое проверяете
Не оценивайте ответ ИИ по убедительности объяснения. Для рекламной задачи нужен проверяемый результат: по каждому запросу модель возвращает одно из двух решений.
exclude— предложить запрос в минус-фразы;keep— не исключать автоматически и оставить для работы специалисту.
Второй класс намеренно объединяет целевые и спорные запросы. Это безопасное правило: если контекста недостаточно, запрос не должен исчезнуть из показов только потому, что модель уверенно написала «нецелевой».
До запуска зафиксируйте правила бизнеса. В учебном примере магазин продаёт только новые кресла, не ремонтирует их, не сдаёт в аренду и работает с доставкой по Беларуси. Поэтому «ремонт офисного кресла» — минус, а «офисное кресло отзывы» — запрос, который нельзя исключать: человек может сравнивать варианты перед покупкой.
Соберите контрольную выборку из реальных типов запросов
Google описывает отчёт по поисковым запросам как данные о фактических поисках, которые вызвали показ рекламы. Из такого отчёта удобно брать материал для проверки, но сама выборка должна отражать вашу кампанию: брендовые и общие запросы, разные регионы, устройства, группы товаров, редкие формулировки и пограничные случаи.
Не отдавайте модели тот же список, на котором вы уточняли промпт. Отложите отдельную контрольную часть и вручную присвойте ей эталонные метки. Для спорных запросов запишите причину решения; если специалисты не согласны между собой, отправьте строку в класс keep, а правило уточните отдельно.
В учебной выборке 20 запросов: 8 действительно нужно исключить, 12 — оставить. ИИ предложил семь минусов.
| Результат сравнения | Количество | Что произошло |
|---|---|---|
| Минус найден верно | 6 | Нецелевой запрос предложен к исключению |
| Минус пропущен | 2 | Нецелевой запрос остался в работе |
| Полезный запрос исключён | 1 | «Офисное кресло отзывы» ошибочно попало в минус |
| Полезный запрос оставлен | 11 | Целевой или спорный запрос не исключён |
Полная учебная выборка сохранена вместе со статьёй. Расчёт даёт 85,7% точности рекомендаций «минус»: шесть верных исключений из семи предложенных. Полнота по минусам — 75%: модель нашла шесть из восьми нецелевых запросов. Общая доля верных решений — 85%, но для публикации списка этого недостаточно: одна ошибка отрезает полезный запрос.
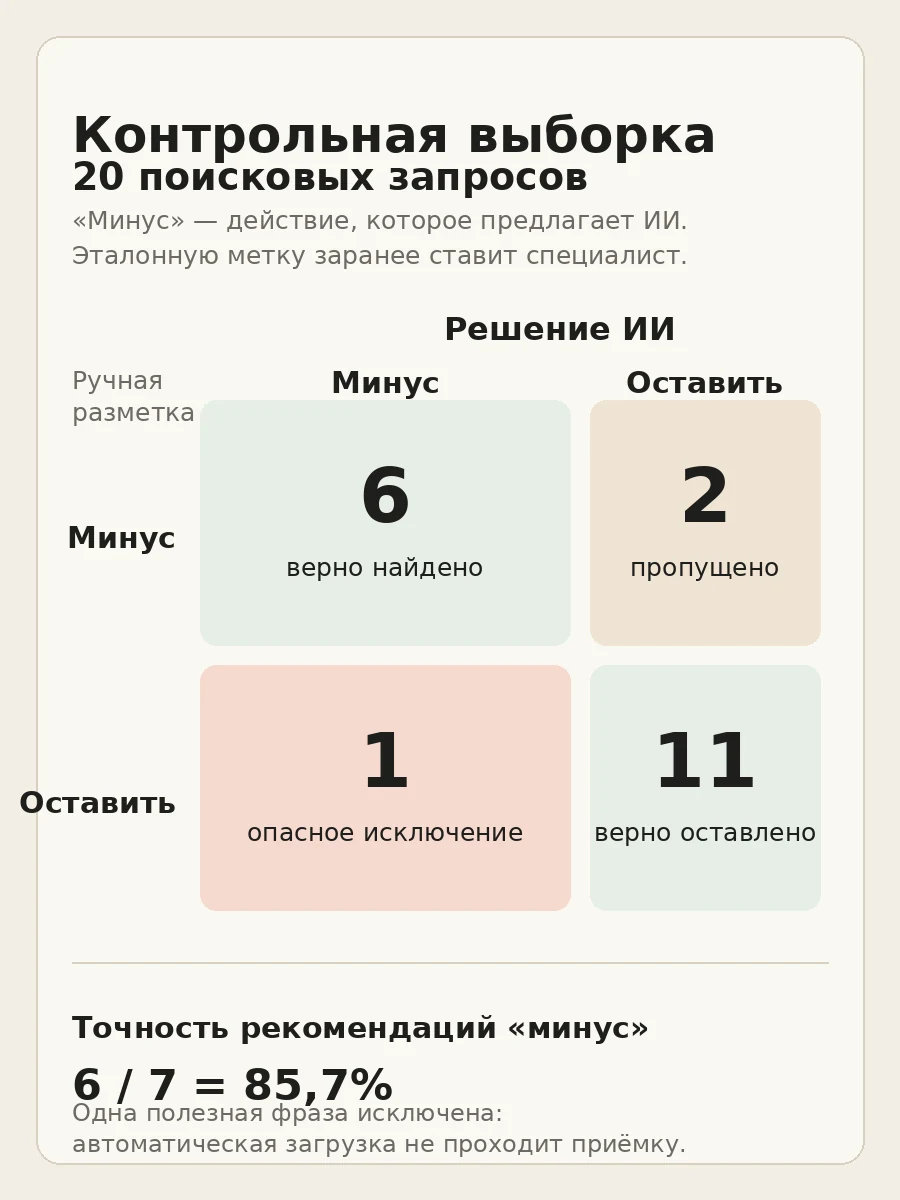
Матрица показывает разные последствия ошибок: пропущенный минус оставляет расход, а ложный минус может убрать полезный спрос.
Почему одной общей точности мало
Если большинство строк легко оставить, модель может показать высокий общий процент и всё равно опасно ошибаться в редких исключениях. Поэтому считайте минимум два показателя.
Точность рекомендаций «минус» отвечает на вопрос: какая доля предложенных исключений действительно нецелевые. Формула для примера: 6 / (6 + 1) = 85,7%.
Полнота по минусам показывает, какую долю всех известных нецелевых запросов модель нашла. Формула: 6 / (6 + 2) = 75%.
Эти ошибки имеют разную цену. Пропущенный минус продолжает расходовать бюджет, но остаётся видимым в следующем отчёте. Ложный минус блокирует потенциально полезный запрос и может скрыть потерю: показов и новых данных по нему уже не будет. Поэтому для автоматической загрузки обычно важнее минимизировать ложные исключения, а полноту можно наращивать повторной ручной проверкой.
В примере ошибочно исключённый запрос накопил 46 BYN учебных расходов, а два пропущенных нецелевых запроса — 50 BYN. Эти суммы нельзя превращать в прогноз экономии: они относятся только к подготовленной таблице и нужны, чтобы проверить расчёт.
Проведите приёмку по шагам
1. Зафиксируйте входные данные
Сохраните дату выгрузки, период, кампанию, группу, поисковый запрос, ключевую фразу, тип соответствия, клики, расход и конверсии. Не смешивайте в одном тесте разные правила бизнеса: например, магазин новых кресел и сервис ремонта будут по-разному размечать слово «ремонт».
2. Сделайте ручной эталон
Специалист размечает контрольную выборку до просмотра ответа ИИ. Для каждой строки нужны метка и короткое основание: ассортимент, география, тип услуги, бренд, этап спроса. Такой эталон позволяет проверить конкретный ответ, а не согласиться с красивым объяснением задним числом.
3. Зафиксируйте версию классификатора
Сохраните промпт, модель, дату запуска и допустимый формат ответа. Лучше требовать строгую таблицу или JSON с полями query, label, reason. Поле уверенности можно использовать для сортировки, но не считать доказательством качества: число выставляет сама модель.
4. Сравните метки автоматически
Для двух классов достаточно таблицы ошибок и простых формул выше. Официальная документация OpenAI по evals использует похожую схему: тестовый набор содержит человеческую эталонную метку, а результат модели сравнивается с ней; данные должны представлять реальные типы входов, с которыми будет работать решение.
5. Разберите каждую ошибку
Сгруппируйте причины: неоднозначное намерение, география, отрицание, бренд, характеристика товара, опечатка, новое правило ассортимента. Исправлять нужно правило или входные данные, а не одну конкретную строку. После изменения промпта или модели прогоните ту же контрольную выборку и новые свежие запросы.
6. Назначьте правило выпуска
Универсального порога нет: он зависит от цены ошибок и объёма данных. Запишите свой критерий до теста. Например: автоматическая загрузка запрещена при любом ложном исключении в критических группах; остальные предложения проходят ручную проверку. Учебный классификатор этот критерий не проходит из-за запроса «офисное кресло отзывы».
7. Проверьте результат уже в рекламной системе
Метка exclude ещё не является готовой минус-фразой. Нужно выбрать уровень применения и тип соответствия, проверить пересечения с рабочими ключами и посмотреть, какие полезные запросы будут затронуты. Google отдельно описывает различия широкого, фразового и точного соответствия минус-слов, а Яндекс рекомендует после добавления минус-фраз проверить, не пропали ли полезные запросы.
Для проверки пересечений используйте материал о конфликтах минус-фраз. Если сначала нужно найти повторяющиеся маркеры в большой выгрузке, начните с N-граммного анализа поисковых запросов и затем проверьте отдельные строки вручную.
Как встроить проверку в регулярную работу
Контрольная выборка не должна быть одноразовой. Добавляйте в неё новые спорные случаи из свежих отчётов, а также запросы, на которых менялись ассортимент, география или условия продажи. Повторяйте тест после замены модели, промпта или схемы меток.
Храните четыре артефакта: исходную выгрузку, ручной эталон, ответ ИИ и отчёт об ошибках. Тогда результат можно воспроизвести, а причину изменения метрик — найти. Общий подход к таким проверкам разобран в материале как оценивать качество ответа ИИ.
Рабочий порядок выглядит так: сначала ИИ сортирует и объясняет, затем скрипт считает ошибки, специалист просматривает ложные исключения и только после этого готовит минус-фразы. Следующий шаг — вернуть прошедшие проверку запросы в процесс обновления семантики после запуска и через несколько дней повторно проверить отчёт по поисковым запросам.
Короткий чек-лист перед загрузкой
- Правила бизнеса и классы записаны до запуска модели.
- Контрольная выборка отделена от примеров, на которых меняли промпт.
- У каждой строки есть ручная метка и причина.
- Посчитаны ложные исключения и пропущенные минусы, а не только общий процент.
- Спорные запросы не исключаются автоматически.
- Проверены тип соответствия, уровень применения и конфликты с ключами.
- После изменения промпта или модели тест повторён на том же эталоне и свежих данных.
Если хотя бы один полезный запрос попал в автоматический список минус-фраз, публикацию списка лучше остановить. Такая остановка — результат приёмки: она показывает, где автоматизация ещё требует ручного контроля.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…