21 сентября Яндекс опубликовал на Hugging Face базовую модель AliceAI-Foundation-80B-A3B-Base и технический отчёт о её обучении. В названии зашита главная идея: 80 млрд параметров дают модели большую общую ёмкость, но для каждого токена активируется около 3 млрд.
Это не готовый чат и не новая версия Алисы для конечного пользователя. Модель выпущена без постобучения и выравнивания поведения. Она предназначена для команд, которым нужна открытая база для собственного ассистента, поиска, RAG, извлечения данных или доменного дообучения.
Главный интерес релиза — сильный русский язык при вычислительной нагрузке класса 3B active и контексте 262 тысячи токенов. Главный компромисс — в памяти всё равно нужно разместить 80 млрд весов.
Карточки ниже Яндекс опубликовал вместе с официальным анонсом модели.
Что означает 80B-A3B
AliceAI Foundation относится к классу Mixture of Experts. Вместо участия всей модели в каждом шаге маршрутизатор выбирает ограниченное число экспертных блоков.
- 80B — общее число параметров. Оно влияет на ёмкость модели и требования к хранению весов.
- A3B — примерно 3 млрд активных параметров на токен. Это ближе к фактическому объёму вычислений на одном шаге генерации.
- 512 экспертов, из которых выбираются 10 routed experts, плюс общий эксперт.
- 48 слоёв с повторяющимся рисунком: три слоя KDA с MoE и один слой обычного Gated Attention с MoE.
- 262 144 токена контекста после этапов обучения на 8K, 32K и 256K.
KDA — линейный механизм внимания. В архитектуре Яндекса он работает в трёх из четырёх слоёв, а полное внимание используется реже. Такой дизайн сдерживает рост KV-кэша на длинных последовательностях.
По техническому отчёту модель обучена с нуля примерно на 18 трлн токенов. Яндекс подчёркивает, что не использовал веса сторонних моделей. Весы и код опубликованы под Apache 2.0.
Сравнение с Qwen 3.5
Корректный ближайший соперник — Qwen3.5-35B-A3B-Base. У обеих моделей около 3 млрд активных параметров и одинаковый базовый контекст 262 тысячи токенов. Но назначение и общий объём отличаются.
| Характеристика | AliceAI Foundation 80B-A3B | Qwen3.5 35B-A3B Base |
|---|---|---|
| Тип | Текстовая base-модель | Мультимодальная base-модель |
| Всего параметров | 80 млрд | 35 млрд |
| Активно на токен | около 3 млрд | около 3 млрд |
| Нативный контекст | 262 144 | 262 144 |
| Эксперты | 512, top-10 + shared | 256, 8 routed + shared |
| Языковой акцент | Русский и английский | 201 язык и диалект в линейке |
| Лицензия | Apache 2.0 | Apache 2.0 |
У Alice больше общей ёмкости при сопоставимых активных вычислениях. У Qwen меньше полный объём весов и шире заявленная мультимодальная и языковая база. Как это скажется на конкретном продукте, зависит от задачи и дообучения.
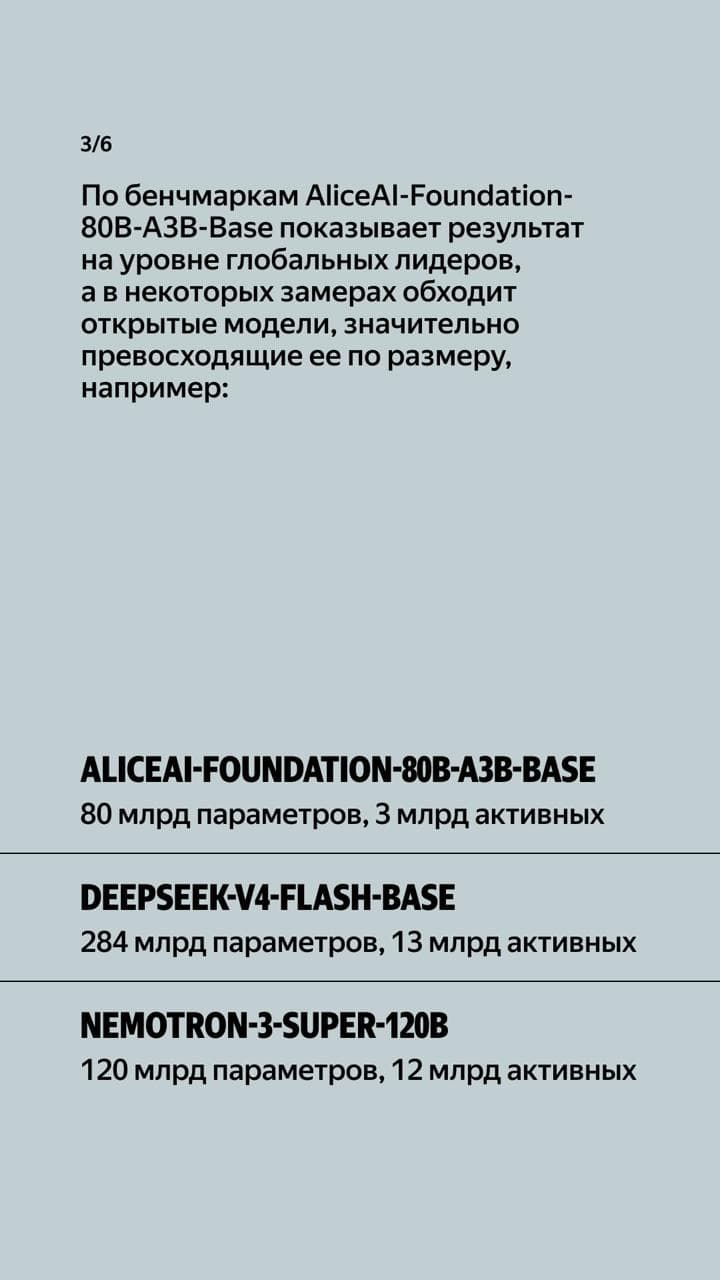
Сравнивать AliceAI Foundation с instruct-версией Qwen некорректно: у готового ассистента есть дополнительное обучение следованию инструкциям. В опубликованной таблице Яндекса сопоставлены базовые модели в одном harness.
Что показывают тесты Яндекса
Ниже часть официальной таблицы. Это единый прогон Яндекса, а не независимый рейтинг.
| Тест | Alice 80B-A3B | Qwen 35B-A3B | GLM-4.5 Air | Nemotron-3 Super | DeepSeek-V4 Flash |
|---|---|---|---|---|---|
| WikiWebFacts RU, 5-shot | 86,5 | 62,4 | 70,2 | 72,8 | 83,2 |
| HardMultiQA RU, 5-shot | 67,9 | 47,2 | 48,6 | 54,5 | 65,4 |
| MMLU-Pro CoT EN, 5-shot | 66,8 | 63,2 | 58,4 | 69,9 | 66,5 |
| SuperGPQA CoT EN, 5-shot | 44,3 | 43,6 | 35,4 | 46,6 | 46,1 |
| MATH-500, 5-shot | 91,1 | 81,9 | 60,2 | 84,8 | 80,7 |
| LiveCodeBench v5–6, p@1 | 50,5 | 50,4 | 22,6 | 50,4 | 38,1 |
| FinQA 128K, 5-shot | 74,1 | 73,5 | 35,5 | 71,7 | 74,1 |
| LongMemEval 128K, 5-shot | 64,6 | 55,6 | 50,6 | 64,8 | 68,0 |
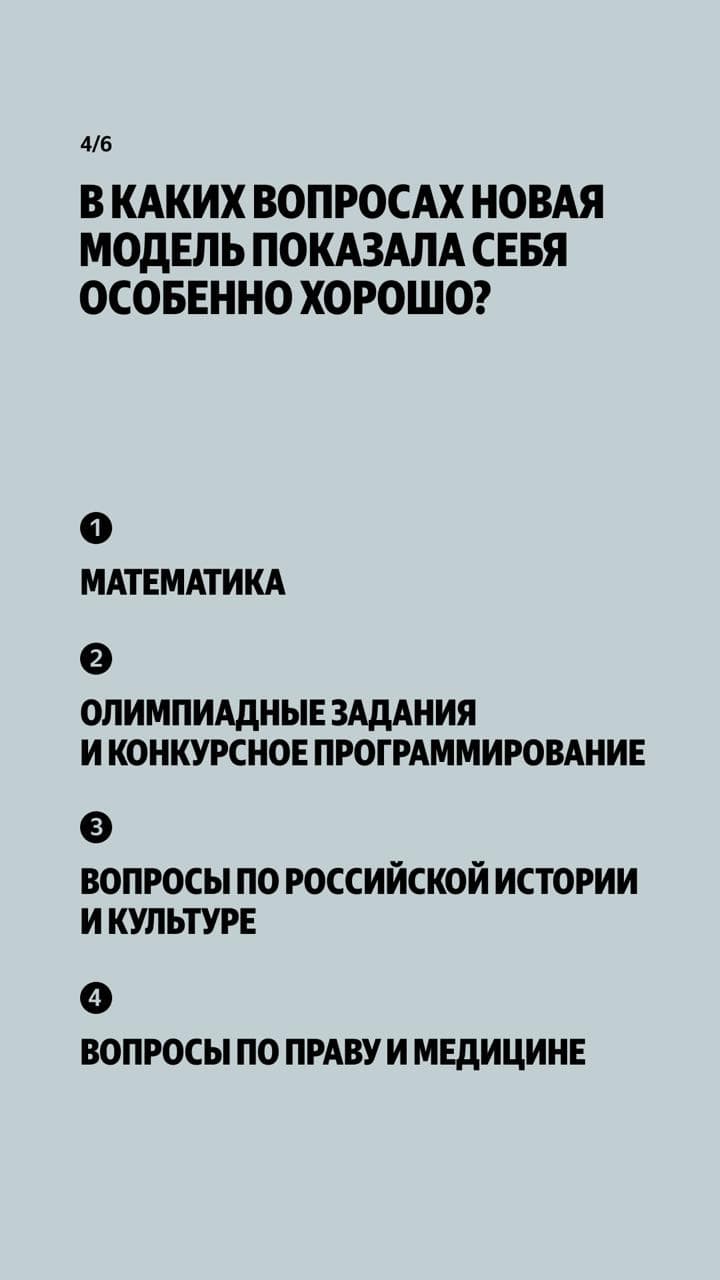
На этом прогоне Alice лидирует в двух русскоязычных фактологических тестах и MATH-500, почти равна Qwen на LiveCodeBench и FinQA, уступает Nemotron и DeepSeek на части англоязычных задач.
В reasoning-пакете картина смешанная. Alice и Qwen получили по 96,7 на AIME 2026 p@32. На Codeforces C++ p@8 Qwen оказался выше: 73,7 против 68,9. На LiveCodeBench p@1 Alice выше — 60,4 против 51,9, а при p@8 модели почти сравнялись: 82,9 и 82,1.
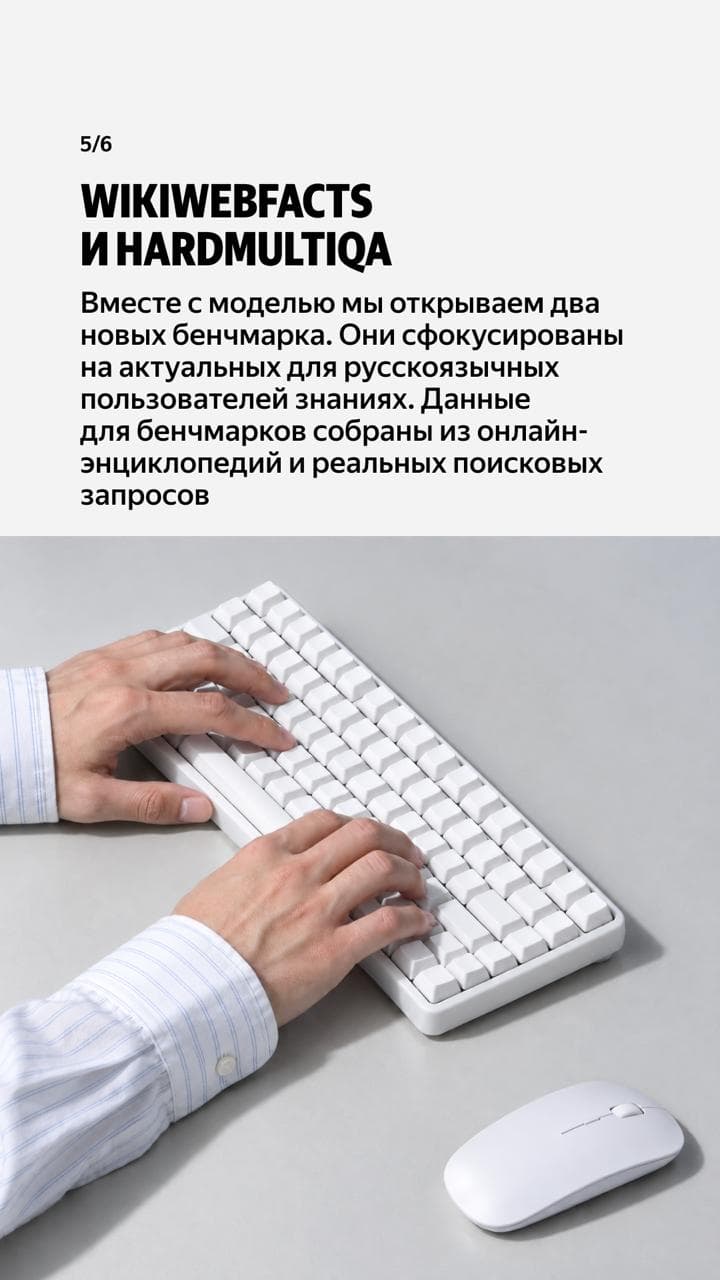
Вывод из этих цифр узкий: в опубликованном Яндексом протоколе модель сильна на русском, математике и длинном контексте при 3B active compute. Это ещё не доказательство общего лидерства. Два самых заметных русскоязычных набора — WikiWebFacts и HardMultiQA — также созданы Яндексом. На Hugging Face доступны вопросы, эталонные ответы и протоколы оценки этих бенчмарков.
Где независимые оценки
На момент публикации релизу меньше суток. Независимых воспроизводимых прогонов в открытых leaderboard и подробных сравнений мы не нашли. На Hugging Face уже есть обсуждения, но они пока не складываются в отдельную оценку качества.
Независимый технический разбор Deniz Genc обращает внимание на правильные ограничения: 3B active не равны 3B памяти, base-модель требует дообучения, а официальные цифры нужно перепроверять. Собственного benchmark-прогона в материале нет.
Поэтому сейчас разумно читать официальную таблицу как заявку на уровень модели и основу для собственного пилота. Рейтинг появится после того, как несколько команд воспроизведут результаты в одинаковой конфигурации.
Как Яндекс экономил ресурсы при обучении
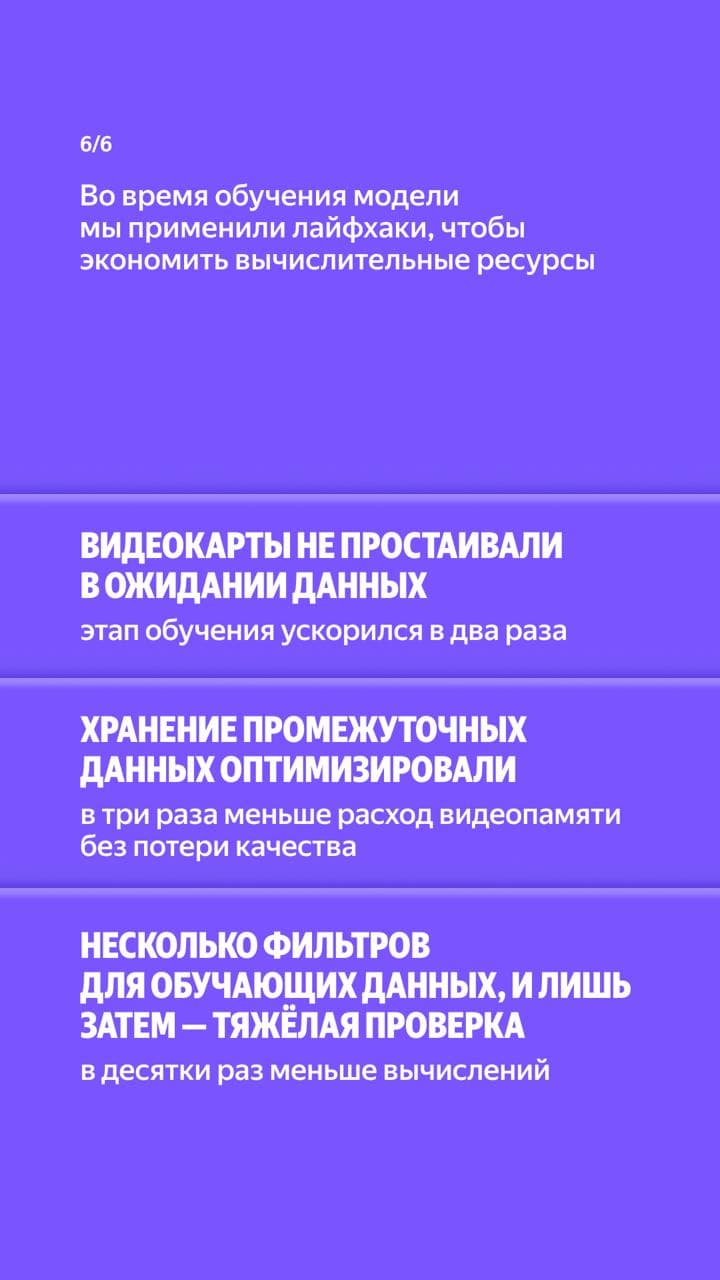
В официальных карточках команда называет три приёма: видеокарты не простаивали в ожидании данных, хранение промежуточных данных потребовало втрое меньше видеопамяти, а дешёвые фильтры сокращали объём дорогой проверки обучающего корпуса. Это детали процесса обучения, а не обещание такой же экономии при пользовательском запуске модели.
Сколько памяти понадобится
В репозитории Hugging Face лежит около 163 ГБ файлов весов. Для BF16 практическая оценка близка к 160 ГБ только на параметры, без запаса под служебные данные, KV-кэш и runtime. Четырёхбитная упаковка теоретически может сократить вес примерно до 45 ГБ, но качество, скорость и поддержка KDA зависят от конкретной реализации.
Яндекс показывает запуск через Transformers с flash-linear-attention и через vLLM. Официальный пример vLLM использует четыре GPU, а пример LoRA рассчитан на четыре ускорителя по 80 ГБ. Точного минимального VRAM для inference авторы не обещают.
Это важный практический барьер. Модель экономит вычисления на токен, но остаётся большой по хранению. Для локальной рабочей станции Qwen3.5-35B-A3B обычно проще как исходная точка; AliceAI Foundation интереснее там, где русский язык и собственное дообучение оправдывают инфраструктуру.
Кому стоит тестировать модель
Релиз имеет смысл для трёх сценариев.
Русскоязычный поиск и RAG
Если продукт работает с длинными русскими документами, договорами, базой знаний или каталогом, есть смысл проверить полноту ответа, точность цитат и устойчивость на 64K–128K контекста.
Доменная base-модель
Apache 2.0 и открытые веса позволяют строить собственное постобучение. Но потребуется набор инструкций, preference data, safety-настройка и продуктовые тесты. Без этого модель будет продолжать текст, а не вести себя как готовый ассистент.
Исследование sparse-архитектур
Связка KDA, редких слоёв полного внимания и 512 экспертов интересна командам, которые оптимизируют пропускную способность и длинный контекст.
Как провести честный пилот
Не начинайте с общего вопроса «какая модель умнее». Соберите одинаковый набор задач для Alice и Qwen.
- Возьмите 100–300 реальных русскоязычных примеров: поиск факта, извлечение полей, суммаризация, ответ с цитатой, код или математика.
- Зафиксируйте одинаковый prompt, контекст, квантование и лимит генерации.
- Оценивайте точность, полноту, наличие выдуманных фактов, задержку, токены в секунду и стоимость инфраструктуры.
- Отдельно сравните base-модели после одинакового способа post-training. Не смешивайте результат исходной base-модели с готовым instruct-релизом.
- Проверьте длинный контекст на своих документах: заявленный размер окна не гарантирует одинаковое качество во всех его частях.
В чём смысл релиза
Яндекс выпустил не замену облачной Алисе, а строительный блок. Его сильная сторона — большая общая ёмкость, русский акцент, длинный контекст и около 3 млрд активных параметров на токен. На официальных тестах это даёт заметное преимущество над Qwen3.5-35B-A3B в русском factual QA и близкий уровень в ряде reasoning-задач.
Цена такого дизайна — 80 млрд весов, сложный runtime и отсутствие готового поведения ассистента. Для большинства локальных экспериментов Qwen будет проще. Для команды с GPU-инфраструктурой и русскоязычным продуктом AliceAI Foundation заслуживает отдельного пилота.
На что опирается разбор
Ссылки на справки и исследования, использованные в статье. Условия конкретного продукта стоит сверять перед применением.
- Официальный релиз AliceAI Foundation — Яндекс Проверено 21.09.2026
- AliceAI-Foundation-80B-A3B-Base — Hugging Face Проверено 21.09.2026
- Технический отчёт AliceAI Foundation — Хабр Проверено 21.09.2026
- Qwen3.5-35B-A3B-Base — Hugging Face Проверено 21.09.2026
- WikiWebFacts — Hugging Face Datasets Проверено 21.09.2026
- HardMultiQA — Hugging Face Datasets Проверено 21.09.2026
- Независимый технический комментарий Deniz Genc Проверено 21.09.2026
Что думаете?
Загружаем комментарии…