Обычная языковая модель хорошо объясняет, пишет и рассуждает. В программном процессе от неё часто требуется более узкое действие: выбрать инструмент, определить срочность обращения, оценить риск команды или решить, какой модели передать задачу.
Для такого шага полный текстовый ответ создаёт лишнюю работу. Его нужно дождаться, разобрать, проверить по схеме и обработать случай, когда модель вернула неожиданный формат.
В сентябре 2026 года TypeSafe AI представила JEV — первую модель из категории, которую компания называет System One Models. JEV получает состояние системы и заранее описанные вопросы, а возвращает типизированные решения, вероятности и оценку уверенности. Модель не предназначена для написания статьи, ответа пользователю или генерации кода.
В этом ограничении и находится причина хайпа: разработчики получили отдельный AI-слой для небольших решений, которые повторяются внутри агентных систем тысячи раз.
Что JEV делает на самом деле
Запрос к JEV состоит из двух основных частей:
state— текстовое или структурированное описание текущей ситуации;questions— набор решений, которые нужно получить.
В публичном API есть три типа вопросов:
| Тип | Что возвращает | Пример |
|---|---|---|
| Choice | распределение вероятностей между заданными вариантами | выбрать модель, инструмент или отдел |
| Score | положение на описанной шкале | оценить срочность, риск или качество |
| Noul | вероятность ответа «да» | проверить, требуется ли ручное подтверждение |
Все варианты ответа задаёт разработчик. Поэтому JEV не может внезапно добавить неизвестное поле или вернуть эссе вместо значения из схемы. TypeSafe называет это отсутствием галлюцинаций, но формулировку нужно читать аккуратно.
JEV гарантирует форму ответа. Он всё ещё способен выбрать неверный вариант. Нулевая доля ошибок схемы и высокая точность решения — разные свойства. Для рабочего процесса нужен порог уверенности, журнал решений и безопасный маршрут при сомнительном ответе.
Откуда взялся хайп
TypeSafe заявляет для JEV задержку примерно 70–500 мс и цену $0,042 за миллион входных токенов; выход модели не тарифицируется отдельно. По собственным workflow-тестам компания показывает преимущество до 193,6 раза по скорости и до 444,6 раза по цене относительно сравниваемых LLM.
Эти цифры выглядят ярко, однако сама TypeSafe перечисляет ограничения:
- workflow-тесты разработала команда компании;
- эталонные вероятности собраны из ответов GPT-6 Astra и Fable 5.1;
- конкурирующие LLM запускались через адаптер TypeSafe;
- выбранные задачи специально имеют форму структурированных решений.
Поэтому корректный вывод звучит уже: JEV может быть очень быстрым и дешёвым на задачах выбора, классификации и оценки. Публичных независимых данных о стабильности на широком наборе production-процессов пока мало. Ранний доступ открылся 15 сентября 2026 года.
Интерес усилился из-за понятного места в агентной архитектуре. Большая модель продолжает исследовать, писать и выполнять сложную работу. JEV принимает частые промежуточные решения: куда идти, что проверять, когда остановиться и где нужен человек.
Реальные примеры, которые уже можно посмотреть
Срочность обращения
В документации TypeSafe и примере LangChain сообщение клиента о сломанном подключении Stripe передаётся как состояние. Вопрос Noul проверяет, есть ли срочность. Ответ возвращает вероятность 0,999, которую система может использовать для приоритета заявки.
Это демонстрационный пример, но он показывает правильную форму задачи: результат сразу превращается в условие программы.
Выбор модели для агента
Интеграция LangChain использует JEV как Model Router Middleware. Разработчик задаёт варианты — например, быструю дешёвую модель и сильную модель для архитектурных решений. JEV выбирает маршрут и сохраняет вероятности в состоянии агента.
Проверка рискованных инструментов
AutoMode Middleware в LangChain проверяет предполагаемый вызов инструмента перед выполнением. Например, команда оболочки может пройти классификацию риска и потребовать подтверждение. Такой классификатор особенно полезен, когда проверка должна занимать доли секунды и выполняться на каждом шаге.
Браузерные агенты, почта и торговый агент
LangChain приводит три ранних проекта сообщества: маршрутизацию browser-use агентов за доли цента, live trading agent и массовую сортировку почты. Это реальные интеграции разработчиков, но опубликованной единой методики оценки их качества пока нет.
Doom и Wikiracing
TypeSafe показывает две собственные демонстрации. В Doom JEV реагирует на текстовое представление состояния игры примерно десять раз в секунду. В Wikiracing модель выбирает следующую ссылку среди сотен вариантов. Обе демонстрации подчёркивают скорость и работу с большим числом заранее допустимых действий. Они не являются доказательством надёжности бизнес-процесса.
Наш тест: JEV выбирал следующий маршрут
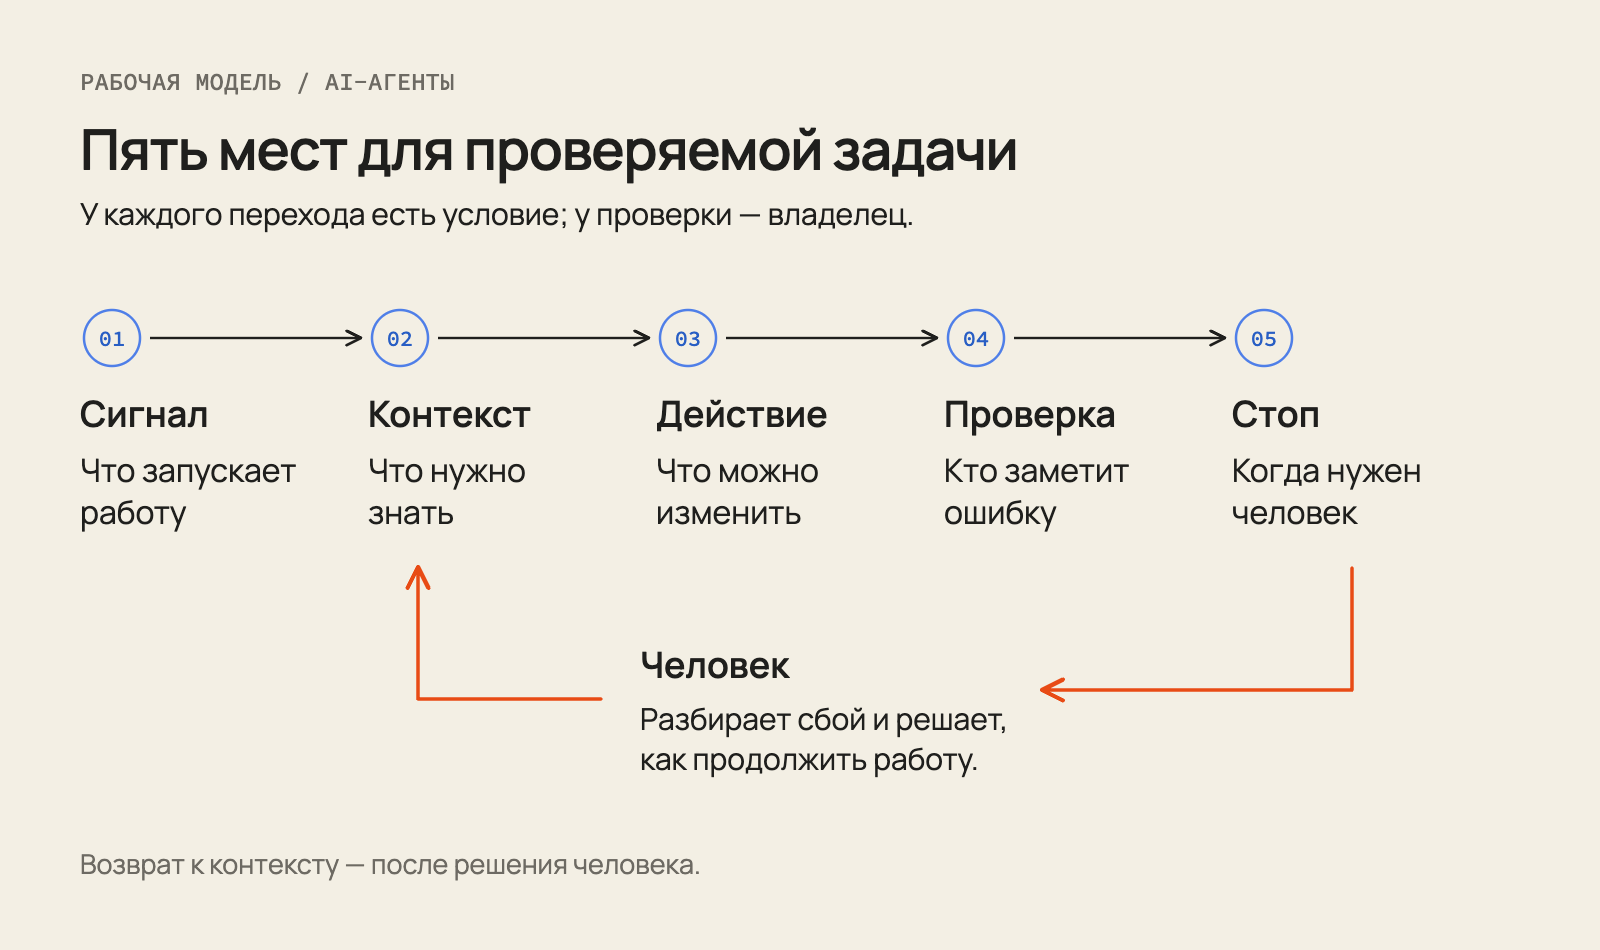
Мы подключили JEV через открытый JevRouter к задаче программирования. Codex сформулировал работу и принимал результат. JevRouter собрал доступные модели в единый список, передал JEV вопрос Choice и затем применил собственные правила доступности, риска и разрешений.
Первая попытка завершилась без решения из-за низкой уверенности. После уточнения доступных возможностей JEV последовательно направлял задачу в бесплатные маршруты. Qwen и Poolside вернули HTTP 429, Cohere дважды завершила запрос без пригодного содержимого. Новые наблюдения возвращались маршрутизатору.
Следующим маршрутом стала платная DeepSeek V4 Flash. Она вернула решение, которое прошло 11 из 11 локальных тестов. Финальный вызов модели и решения маршрутизатора вместе стоили меньше 0,03 американского цента.
Этот запуск подтверждает работу связки; универсального превосходства JEV он не доказывает. Важны три наблюдения:
- JEV выбирал следующий шаг и не выполнял задачу за основную модель.
- Низкая уверенность превратилась в
no_decision; скрытого случайного выбора не произошло. - Приёмку обеспечили локальные тесты; вероятность маршрута не служила доказательством качества кода.
Что добавляет JevRouter
JevRouter на GitHub — независимый локальный маршрутизатор, построенный поверх JEV. Он объединяет модели, субагентов, скиллы, MCP-инструменты и CLI в один список кандидатов.
Граница ответственности разделена явно:
- JEV рассчитывает вероятности выбора;
- JevRouter проверяет доступность, права, риск и необходимость подтверждения;
- основной агент выполняет выбранное действие и проверяет результат.
Маршрутизатор работает в decision-only режиме: он не запускает выбранный инструмент автоматически. Это полезная защита для ранней технологии — решение модели остаётся рекомендацией внутри обычной системы полномочий.
В небольшом тесте авторов JevRouter на десяти задачах Toolathlon JEV точнее предсказывал первые пять вызовов инструментов, работал примерно в 5,5 раза быстрее и стоил примерно в семь раз дешевле DeepSeek V4.1 Flash. Сам репозиторий честно ограничивает вывод: эксперимент измерял только порядок маршрутизации; долю полностью завершённых задач он не оценивал.
Где посмотреть код
- TypeSafe AI на GitHub — официальная организация.
- Официальный Python SDK.
- Официальный JavaScript SDK.
- System One adapter для обычных LLM — позволяет сравнивать JEV с языковыми моделями через похожий контракт.
- JevRouter — маршрутизация моделей, инструментов, скиллов и субагентов.
- Интеграция LangChain — примеры классификации, model routing и tool-risk gating.
Есть ли аналоги
Прямых зрелых аналогов с тем же API, параллельными типизированными вопросами и калиброванной уверенностью пока немного. Соседние решения закрывают отдельные части задачи.
| Решение | Что общего | Главное отличие |
|---|---|---|
| RouteLLM | выбирает между сильной и дешёвой LLM | специализируется на стоимости и качестве ответа модели |
| vLLM Semantic Router | маршрутизирует запросы между моделями и инфраструктурой | полноценный open-source routing/control layer; отдельной облачной decision model в нём нет |
| обычный классификатор BERT/ModernBERT | быстро выбирает класс и может работать локально | требует данных и обучения под конкретную схему |
| LLM со Structured Outputs | возвращает данные по заданной схеме | сохраняет задержку и стоимость авторегрессионной генерации |
| правила и JSON-конфигурация | предсказуемо выбирают действие | плохо обрабатывают неоднозначный естественный язык без заранее описанной логики |
На GitHub уже появляются открытые попытки повторить System One-подход. Их результаты интересны для эксперимента, но зрелость, лицензии данных и сопоставимость тестов нужно проверять отдельно.
Какие задачи стоит попробовать первыми
JEV подходит для шага, который можно сформулировать как ограниченный выбор, шкалу или вероятность:
- выбрать модель по сложности, цене и доступности;
- направить обращение в отдел и оценить срочность;
- выбрать инструмент агента из разрешённого набора;
- поставить вызов на ручное подтверждение по уровню риска;
- оценить соответствие ответа редакционному чек-листу;
- ранжировать документы перед дорогим RAG-запросом;
- определить следующий шаг сценария поддержки;
- проверить, требуется ли резервный маршрут после ошибки провайдера.
Задача подходит для первого пилота, если возможные ответы известны заранее, ошибку можно заметить, а безопасный fallback уже определён.
Где JEV пока слабый выбор
JEV не заменяет модель, когда нужен новый текст, код, исследование, объяснение или план. Он также не снимает ответственность с системы, которая выполняет решение.
Осторожность нужна в трёх случаях:
- ошибка сразу меняет деньги, права или production;
- классы постоянно меняются и их нельзя описать перед запросом;
- нет размеченных примеров и способа проверить калибровку на своей области.
В таких процессах JEV можно использовать как дополнительный сигнал. Финальное действие остаётся за правилом, человеком или проверяемым исполнительным контуром.
Как провести полезный тест
- Выберите одно повторяющееся решение с известными вариантами.
- Соберите 50–200 прошлых примеров и ожидаемые ответы.
- Задайте порог уверенности и fallback до запуска.
- Сравните JEV с простыми правилами, дешёвой LLM и существующим классификатором.
- Измерьте точность, калибровку, задержку, стоимость и долю ручных проверок.
- Запустите теневой режим: записывайте решения без внешнего действия.
- Разрешайте автоматическое выполнение только для класса с приемлемой ценой ошибки.
Главная ценность JEV — частое маленькое решение внутри большого процесса. Хайп станет полезным инструментом, если вероятности модели связаны с порогом, журналом, fallback и независимой проверкой результата.
Источники
- TypeSafe AI — Introducing System One Models & Jev, 15.09.2026.
- TypeSafe AI — документация, проверено 21.09.2026.
- LangChain — Building a Harness with Jev, 17.09.2026.
- TypeSafe AI — GitHub, проверено 21.09.2026.
- BillionsBobby/JevRouter, проверено 21.09.2026.
- RouteLLM, проверено 21.09.2026.
- vLLM Semantic Router, проверено 21.09.2026.
Ограничения
- JEV находится в раннем доступе с 15 сентября 2026 года.
- Основные сравнительные показатели скорости, цены и качества опубликованы TypeSafe.
- Ранние проекты сообщества подтверждают интерес к технологии, но пока редко публикуют воспроизводимые production-метрики.
- WiseLab провёл один тест JevRouter на синтетической задаче; он подтверждает работоспособность связки и не служит общим рейтингом моделей.
Что думаете?
Загружаем комментарии…