Рекламный отчёт удобно отдать ИИ для группировки причин отказа, поиска аномалий или подготовки сводки. Но в одной выгрузке с расходом и кампаниями часто лежат имя, телефон, email, внутренний ID и комментарий менеджера. Создайте отдельную копию для анализа: оставьте только поля задачи, замените рабочие ключи стабильными токенами и проверьте результат до загрузки.
Сначала сформулируйте вопрос к данным
Состав файла зависит от задачи. Для сравнения CPL по кампаниям обычно достаточно даты, кампании, расхода и числа лидов. Для анализа квалификации понадобится статус, но не телефон клиента. Для группировки возражений нужен текст обращения — тогда безопаснее заранее выделить категории внутри контролируемой среды, а наружу передавать уже категорию, а не исходный комментарий.
Составьте таблицу полей до экспорта:
| Поле | Нужно для задачи | Действие |
|---|---|---|
campaign | Да | оставить |
spend_byn | Да | оставить |
qualified | Да | оставить |
created_at | Нужна дата | отбросить точное время |
lead_id | Нужна связь строк | заменить токеном |
| имя, телефон, email | Нет | удалить |
manager_comment | Нет | удалить целиком |
Такой список лучше правила «уберём очевидное»: он связывает каждое поле с задачей и показывает, зачем оно осталось.
Удаление имени ещё не заканчивает работу
Прямые идентификаторы заметны сразу. Сложнее сочетания, которые выделяют одну запись: точное время заявки, небольшой населённый пункт, редкий товар и дословный комментарий. Если строку можно сопоставить с человеком по другим доступным данным, риск сохраняется.
Ослабляйте детализацию до уровня, достаточного для анализа. Время можно свести к дате или неделе, точный адрес — к городу, редкий товар — к категории. После каждого упрощения проверьте, остаётся ли возможным нужный расчёт. Если задача требует часовой сезонности, терять час нельзя — тогда стоит агрегировать строки по часу и кампании, а не передавать каждую заявку.
NIST определяет деидентификацию через невозможность связать оставшиеся данные с конкретным человеком и отдельно предупреждает об ограничениях традиционных методов. Поэтому слово «анонимно» нельзя выводить только из отсутствия столбца name: важен весь набор и внешние данные, с которыми его можно сопоставить.
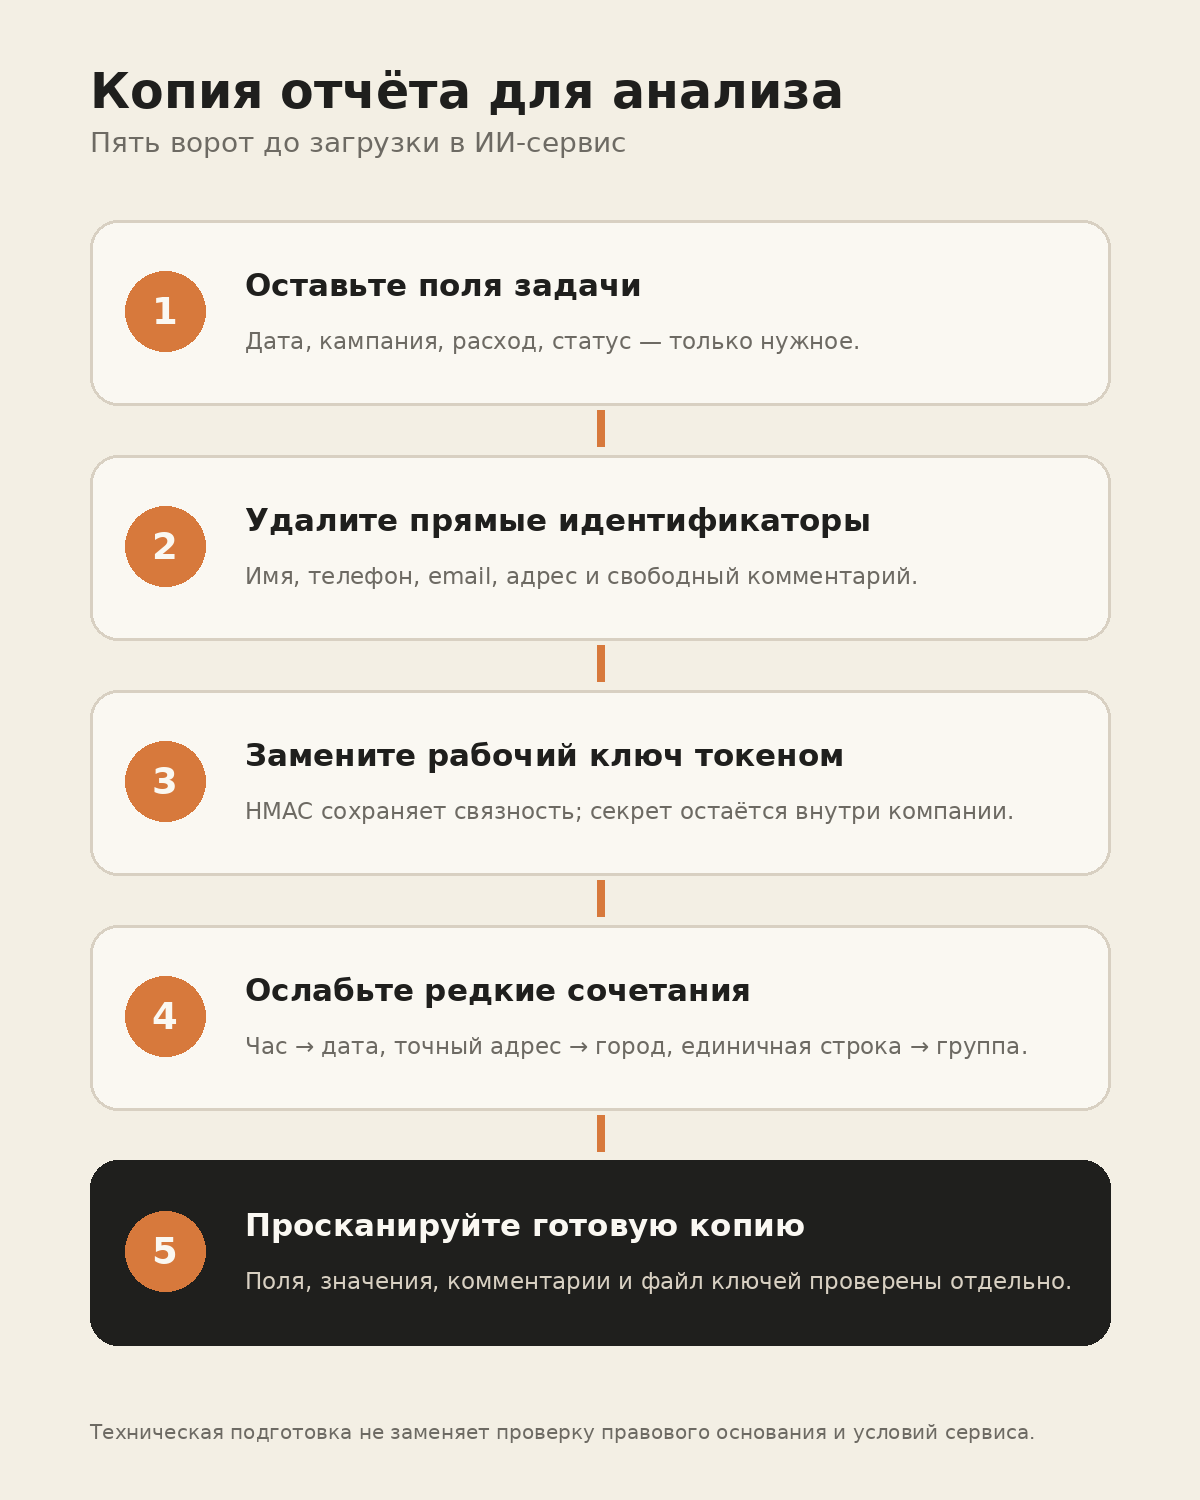
Сначала сокращаем набор полей, затем удаляем идентификаторы, токенизируем нужный ключ, ослабляем редкие сочетания и проверяем готовую копию.
Когда нужен стабильный ключ строки
Иногда ИИ должен вернуть список спорных строк, а аналитик — связать их с внутренней системой. Последовательные номера вроде 1, 2, 3 подходят только для одного файла. Простой SHA-256 от телефона или email тоже слаб: распространённые значения можно перебрать и сравнить хэши.
Для учебного примера используем HMAC-SHA-256 с секретом, который остаётся внутри компании. Один исходный lead_id даёт одинаковый токен в повторных выгрузках, но вычислить токен без секрета сложнее. Таблицу соответствий и сам секрет в ИИ-сервис не загружают.
Это псевдонимизация, а не автоматическое доказательство анонимности. Токен позволяет связывать записи, поэтому доступ к нему и срок хранения тоже нужно ограничивать.
Воспроизводимый пример
Ниже — вымышленные данные. Скрипт оставляет шесть полей, округляет время до даты, заменяет lead_id HMAC-токеном и завершает работу с ошибкой, если в готовом CSV остались значения, похожие на email или телефон.
import csv, hashlib, hmac, os, re
from datetime import datetime

secret = os.environ["REPORT_HMAC_KEY"].encode()
email = re.compile(r"\b[A-Z0-9._%+-]+@[A-Z0-9.-]+\.[A-Z]{2,}\b", re.I)
phone = re.compile(r"(?<!\w)\+?\d{9,15}(?!\w)")

def token(value):
    return hmac.new(secret, value.encode(), hashlib.sha256).hexdigest()[:16]

with open("leads_input.csv", encoding="utf-8", newline="") as f:
    rows = list(csv.DictReader(f))

prepared = [{
    "date": datetime.fromisoformat(r["created_at"]).date().isoformat(),
    "row_id": token(r["lead_id"]),
    "city": r["city"],
    "campaign": r["campaign"],
    "spend_byn": r["spend_byn"],
    "qualified": r["qualified"],
} for r in rows]
Полный скрипт из комплекта статьи записывает результат и сканирует его. Запуск:
REPORT_HMAC_KEY='локальный-секрет' python prepare_report.py \
  leads_input.csv report_for_ai.csv
В учебном файле остаются три строки и шесть столбцов. Имена, телефоны, email, точное время, исходный lead_id и комментарий отсутствуют. Проверка регулярными выражениями полезна как стоп-сигнал, но не распознаёт все способы записи идентификаторов и не оценивает редкие сочетания — их нужно смотреть отдельно.
Проверьте свободный текст и служебные листы
Комментарии менеджеров особенно опасны: в них оказываются телефон, адрес доставки, имя родственника или детали заказа, хотя отдельные поля уже удалены. Если текст не нужен, удаляйте весь столбец. Если нужен, определите категории заранее и проведите разметку внутри одобренного контура.
Проверьте весь файл, а не только главный лист. В XLSX могут остаться скрытые листы, примечания, формулы, именованные диапазоны и история в соседней вкладке. Надёжнее экспортировать разрешённые столбцы в новый CSV, чем удалять лишнее из рабочей книги и надеяться, что ничего не забыто.
Перед загрузкой пройдите пять проверок
- Задача: каждое оставшееся поле нужно для указанного анализа.
- Идентификаторы: прямые поля и свободный текст удалены либо обработаны внутри контролируемой среды.
- Связность: если нужен
row_id, используется отдельный токен; секрет и таблица соответствий не передаются вместе с файлом. - Редкие сочетания: точность времени, географии, товара и других признаков снижена до необходимого уровня.
- Условия обработки: владелец данных проверил правовое основание, договор и настройки сервиса, географию обработки, доступы и срок хранения.
Закон Республики Беларусь № 99-З регулирует обработку персональных данных, а Национальный центр защиты персональных данных напоминает: ответственность за меры защиты остаётся у оператора. Техническая подготовка CSV не заменяет правовую оценку конкретной передачи. Если основание, договорные условия или маршрут данных не подтверждены, файл не загружают.
После анализа сохраните копию входного файла, версию скрипта и полученный результат рядом с задачей. Затем принимайте сводку по отдельному протоколу: сверяйте row_id, контрольные суммы и формулы по материалу о проверке AI-сводки рекламного отчёта. Общие ошибки фактов и выводов разобраны в статье о качестве ответов ИИ.
Готовая копия отвечает на рабочий вопрос, не содержит ненужных идентификаторов, проходит автоматический и ручной просмотр, а её передачу разрешил владелец процесса. Только после этого её можно использовать как вход для анализа.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…