Лемматизатор нашёл несколько одинаковых по словарным формам запросов и оставил по одной строке. Перед удалением проверьте каждую группу по четырём признакам: задача пользователя, предложение, регион и посадочная страница. Совпадение лемм само по себе подтверждает только сходство словоформ.
Для приёмки нужен не просто короткий список, а карта преобразования: исходная строка, сохранённая строка, причина объединения и решение специалиста. Тогда удаление можно повторить, проверить и при необходимости отменить.
Что считать безопасным дублем
В лемматизаторе WiseLab режим поисковых фраз сравнивает строки по леммам с сохранением порядка слов, а широкая группировка может не учитывать порядок. Инструмент оставляет первую исходную фразу группы, удалённые строки нужно проверить вручную.
Безопасным дублем можно считать пару, у которой одновременно совпадают:
- задача человека;
- товар или услуга;
- география и другие условия предложения;
- подходящая посадочная страница.
Например, инструмент показывает как дубль учебную пару «купить красные кроссовки» и «купить красных кроссовок». Словоформы различаются, а коммерческая задача и подходящая страница могут быть одинаковыми. Решение всё равно относится к конкретному проекту: если одна формулировка выделена под отдельную группу или объявление, это нужно увидеть до удаления.
Лемматизация не определяет поисковое намерение. Морфологический движок возвращает варианты грамматического разбора и начальную форму слова; смысл всей фразы, предложение бизнеса и структуру сайта он не проверяет. Документация Az.js также показывает, что одно слово может иметь несколько вариантов разбора, упорядоченных по вероятности.
Учебная проверка на шести строках
Возьмём условный список магазина кресел. Он нужен для демонстрации метода и не описывает реальную кампанию.
| ID | Исходная фраза | Предварительное решение | Причина |
|---|---|---|---|
| K01 | купить офисное кресло | Сохранить | Базовая коммерческая формулировка |
| K02 | купить офисные кресла | Кандидат в дубль K01 | Число слова изменилось, задача и посадочная совпадают |
| K03 | ремонт офисного кресла | Сохранить отдельно | Другая услуга и другая посадочная |
| K04 | офисное кресло б/у | Сохранить отдельно или исключить | Другая модель сделки; решение зависит от ассортимента |
| K05 | купить офисное кресло Минск | Сохранить отдельно | Явная география может влиять на группу и объявление |
| K06 | купить кресло для офиса | Проверить вручную | Похожая задача, но автоматическое совпадение не подтверждает одинаковый охват |
В этой таблице только K02 можно объединить с K01 по заранее заданным условиям. K03, K04 и K05 содержат самостоятельные признаки намерения. K06 требует решения специалиста: форма похожа, но нужно сверить фактические поисковые запросы и структуру кампании.
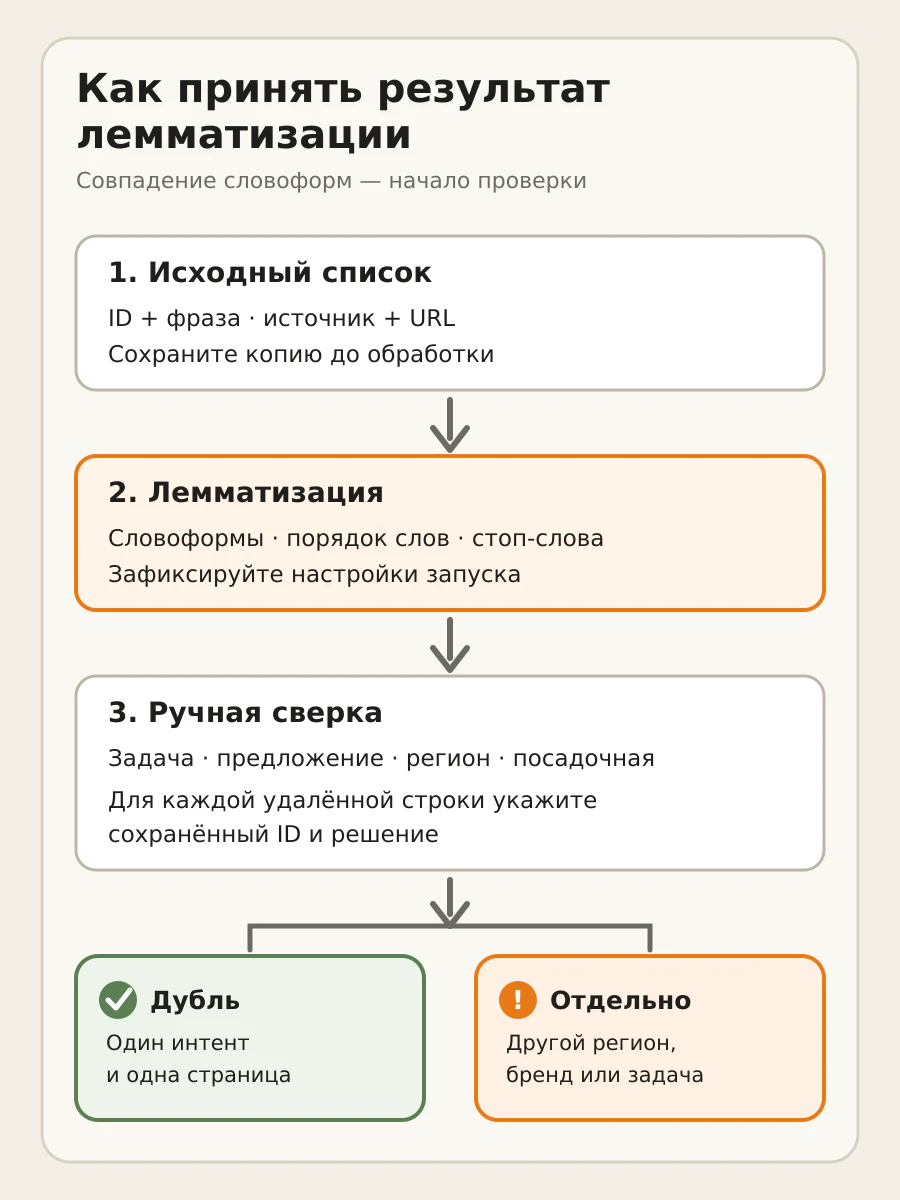
Сначала нормализуйте словоформы, затем разделите совпадения по задаче, предложению, региону и посадочной. Только подтверждённые пары переходят в удаление.
Как провести приёмку
1. Зафиксируйте исходник
Добавьте постоянный ID каждой строке и сохраните копию списка до обработки. Рядом укажите источник фразы: планировщик, поисковый запрос, каталог, интервью или редакционная гипотеза. Частотность и статистику храните в отдельных колонках с периодом и источником; лемматизация не подтверждает спрос.
Без ID трудно восстановить, какая строка исчезла, если формулировки похожи. Позиция в таблице для этого ненадёжна: сортировка меняет номера строк.
2. Начните с консервативного режима
Выберите «Поисковые фразы», сохраните порядок слов и не удаляйте стоп-слова в первом проходе. Такой результат проще проверить: меньше признаков исчезает одновременно. Широкую группировку запускайте отдельно и сравнивайте с базовым результатом.
Особенно внимательно проверяйте предлоги и направления. Учебные фразы «доставка дивана из Минска» и «доставка дивана в Минск» содержат почти тот же набор значимых слов, но описывают противоположный маршрут. Если при обработке убраны стоп-слова и порядок не учитывается, различие легче потерять.
3. Постройте карту удалений
Для каждой удалённой строки заполните пять полей:
| Поле | Что записать |
|---|---|
source_id | ID исходной строки |
kept_id | ID сохранённого представителя |
same_intent | Да, нет или требуется проверка |
same_landing | Конкретный URL либо причина его отсутствия |
decision | Объединить, вернуть, вынести в отдельную группу |
Если нельзя указать сохранённого представителя, удаление нельзя нормально проверить. Верните строку в рабочий список и разберите её отдельно.
4. Проверьте признаки, которые словарь знает хуже бизнеса
Страница инструмента предупреждает о ручной проверке новых слов, брендов и омонимов. В рабочем списке добавьте к ним:
- модели и артикулы;
- аббревиатуры и транслитерацию;
- города и районы обслуживания;
- слова «из», «в», «для», если они меняют направление или назначение;
- отрицания;
- тип сделки: купить, арендовать, ремонтировать, заказать консультацию.
Эти признаки не нужно автоматически считать ошибками движка. Они просто требуют бизнес-решения, которого нет в морфологическом словаре.
5. Выберите представителя группы осознанно
Инструмент сохраняет первую исходную фразу. Поэтому порядок входного файла может случайно определить формулировку, которая останется в ядре. После проверки выберите представителя по задаче: естественная формулировка, подходящая посадочная и понятная связь с группой объявлений.
Не переносите лемму вместо исходного запроса в рекламный кабинет. Лемма нужна для сравнения, а рабочая фраза должна оставаться понятной человеку и соответствовать синтаксису площадки.
Что лемматизация не заменяет
Кластеризацию по посадочным
Две фразы могут выглядеть почти одинаково, но вести на разные страницы. «Купить офисное кресло» и «ремонт офисного кресла» относятся к одной предметной области, однако требуют разных предложений. Критерий объединения — возможность честно ответить на обе задачи одной страницей, а не общие существительные.
Для расширения и последующей чистки используйте обработчик ключевых слов, но отдельно проверяйте смысл комбинаций и реальный спрос. Сам инструмент прямо отмечает, что автоматическая чистка не определяет интент.
Анализ фактических запросов
Подготовленное ядро показывает план, а отчёт поисковых запросов — формулировки, по которым уже были показы. N-грамм-анализ помогает найти повторяющиеся смыслы и связать их с расходом без двойного подсчёта строк. Это следующий шаг после запуска, а не замена приёмки исходного списка.
Настройку минус-слов
Удалённый дубль не становится минус-словом. В Яндекс Директе минус-слова и минус-фразы применяются на разных уровнях, а конкретную словоформу можно фиксировать оператором !; после добавления минус-фраз официальная справка рекомендует проверить исключённые запросы. Сначала решите, что строка действительно описывает неподходящий спрос, затем проверьте механику площадки.
Перед загрузкой полезно пройти отдельную проверку конфликтов минус-фраз. Она отвечает на другой вопрос: не закрывают ли исключения действующие ключевые фразы.
Критерий готовности
Очищенный список можно принимать, когда у каждой удалённой строки есть исходный ID, сохранённый представитель и объяснимое совпадение задачи, предложения, региона и посадочной. Спорные бренды, модели, направления и типы сделки возвращены на ручную проверку.
Сохраните исходник, настройки запуска, карту удалений и финальный список как один комплект. Тогда команда сможет повторить обработку после обновления семантики и увидеть, почему конкретная фраза исчезла, вместо попытки восстановить решение по памяти.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…