Два промпта могут давать убедительные рекламные тексты, но выбор «этот звучит лучше» плохо воспроизводится. Перед запуском скройте названия версий, прогоните их на одинаковых брифах, сначала отсейте фактические ошибки, а затем сравните оставшиеся пары по одному критерию.
Попарный тест подходит, когда оба варианта уже соблюдают формат, но команда спорит о ясности, соответствии запросу или силе аргумента. Он помогает выбрать следующую версию промпта для ограниченного теста. Он не показывает, какой текст даст больше продаж: это проверяют после офлайн-приёмки на реальном A/B-тесте с заранее настроенным измерением.
Сначала отделите стоп-ошибки от предпочтений
До генерации соберите небольшой набор одинаковых заданий. Для каждого задания сохраните исходный бриф, разрешённые факты, запрещённые обещания, площадку и лимит длины. Меняйте только то, что хотите проверить: например, системную инструкцию. Модель, параметры и входные данные оставьте одинаковыми и запишите их версии.
Сначала проверьте каждый текст отдельно. Неподтверждённая скидка, выдуманный срок доставки, неверная цена или нарушение обязательного ограничения — стоп-ошибка. Такой вариант нельзя «спасти» голосованием за удачную формулировку. Проверка коммерческих обещаний по источникам разобрана отдельно в материале как проверить оффер от ИИ перед запуском рекламы.
Только пары, где оба текста прошли обязательные условия, переходят к сравнению. Выберите один вопрос для оценщика: «Какой вариант точнее отвечает задаче и легче читается без потери смысла?» Если одновременно спросить про тон, оригинальность, ясность, полноту и убедительность, причины выбора смешаются.
Подготовьте слепой лист сравнения
Скройте названия промптов и показывайте варианты как X и Y. Порядок меняйте случайно; при повторной оценке поменяйте стороны. Это помогает заметить выбор первого варианта по привычке. OpenAI отдельно предупреждает о позиционном смещении и склонности оценщиков-моделей предпочитать более длинные ответы; тот же контроль порядка полезен и при человеческой проверке.
Рабочая строка может выглядеть так:
| Поле | Что записать |
|---|---|
case_id | стабильный номер брифа |
required_facts | факты, которые разрешено использовать |
text_x, text_y | два анонимных результата |
hard_gate | PASS или код стоп-ошибки |
preference | X, Y или TIE |
reason_code | relevance, clarity, constraint, unsupported |
reviewer | кто и когда проверил |
Разрешите ничью. Вынужденный выбор создаёт победителя даже там, где разницы нет или оба текста слабы. Для спорных пар нужен второй оценщик; расхождение сохраняют как результат, а не стирают средним баллом.
Учебный пример: победитель с критичной ошибкой
У интернет-магазина мебели есть 12 вымышленных брифов. Для одного из них разрешены только два факта: доставка по Минску занимает 1–2 рабочих дня, сборка оплачивается отдельно. Скидка и доставка день в день не подтверждены.
Вариант X: «Кресло A17 доставим по Минску за 1–2 рабочих дня. Стоимость сборки уточните при заказе».
Вариант Y: «Кресло A17 привезём сегодня со скидкой 20% и бесплатной сборкой».
У Y три неподтверждённых условия, поэтому эта пара получает hard_gate=FAIL и не участвует в голосовании за стиль. На полном учебном наборе получилась такая ведомость:
| Результат | Число пар |
|---|---|
| Устойчиво выбран A | 3 |
| Устойчиво выбран B | 5 |
| Ничья | 2 |
| Выбор изменился после перестановки X/Y | 2 |
| Критичные ошибки A / B | 0 / 1 |
Промпт B чаще выигрывал по формулировке, но один раз придумал коммерческое условие. Решение — не заменять A, исправить инструкцию B и повторить весь набор. Числа учебные: они показывают логику решения, а не качество конкретной модели.
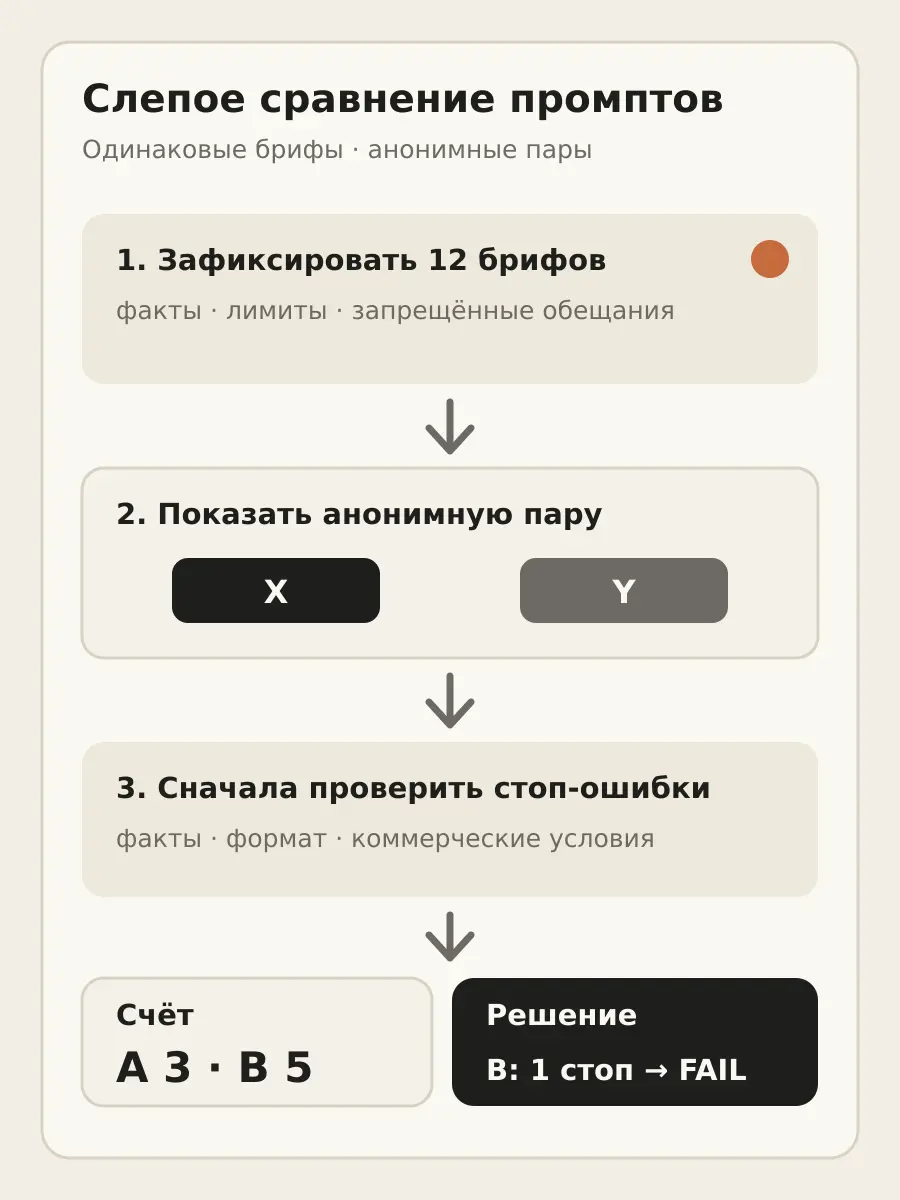
Сначала проходят обязательные условия; предпочтение считают только для допустимых пар.
Примите решение до просмотра итогов
Заранее задайте правило выпуска. Например: ноль неподтверждённых коммерческих условий, ноль нарушений формата, не меньше восьми устойчивых предпочтений из 12 и не больше двух пар, чувствительных к порядку. Это локальные рабочие пороги, а не отраслевой стандарт. NIST рекомендует выбирать метрики по назначению системы и заранее определять допустимые пределы качества и действия при их нарушении.
Не подгоняйте правило после подсчёта. Если новая версия проиграла, сохраните не только общий счёт, но и коды причин. Пять проигрышей по clarity требуют другой правки, чем один unsupported, который блокирует передачу текста в рекламу.
Что автоматизировать, а что оставить человеку
Формат, длину, наличие обязательной фразы и запрещённые слова можно проверять автоматически. Сопоставление с карточкой фактов тоже стоит сделать отдельным этапом. Ясность и соответствие задаче лучше сначала откалибровать на человеческих решениях: несколько примеров PASS, FAIL и TIE помогают согласовать критерий.
Модель можно подключить как дополнительного оценщика, но не считать её голос эталоном. Сначала измерьте совпадение с решениями специалистов, проверяйте обе перестановки X/Y и сохраняйте случаи расхождения. Общий порядок проверки фактов, расчётов и выводов описан в статье как проверять качество ответов ИИ.
После офлайн-PASS передайте выбранный вариант в небольшой реальный тест. Сохраните идентификатор промпта рядом с объявлением, разделите показы корректно и заранее определите основную метрику. Попарная проверка отвечает на вопрос «какой текст безопаснее и лучше по заданному критерию», но не заменяет данные о кликах, заявках, продажах и марже.
Ограничения
Двенадцать учебных пар помогают отладить процесс, но не дают статистической гарантии. Набор должен отражать ваши площадки, товары, язык и типичные ошибки; после новых инцидентов его дополняют. Если тексты заметно различаются по длине или структуре, фиксируйте это как отдельный фактор. Для регулируемых тем и юридически значимых обещаний нужна профильная проверка специалиста.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…