Если складывать частотности широкой фразы и её уточнений, один поиск может попасть в итог несколько раз. Сначала определите, какие наборы запросов описывает каждая строка, и сохраните регион, период, устройство и операторы. После этого решайте, какие числа вообще можно сопоставлять.
Проблема возникает при оценке новой категории, расширении семантики и проверке таблицы подрядчика: сумма выглядит как размер спроса, хотя складываются пересекающиеся группы. Удаление одинаковых строк такую ошибку не устраняет.
Что означает число рядом с фразой
По справке Вордстата, сервис показывает статистику поисковых обращений с заданными словами и их формами. На вкладке «Топы запросов» есть формулировки, содержащие исходную фразу, и похожие запросы. Это разные способы поиска идей; они не образуют автоматически непересекающиеся части рынка.
У числа есть условия измерения. Для магазина в Минске статистика по всему миру или по другой стране отвечает на другой вопрос. Фильтр устройств тоже меняет срез. Сохраните фактически выбранную географию, а не только название города в самой фразе: запрос со словом минск и фильтр региона «Минск» выполняют разные задачи.
Период проверяйте по вкладке. В «Динамике» месяц означает календарный месяц, а региональная таблица описывает последние 30 дней. Числа из этих представлений нельзя считать сопоставимыми только потому, что оба периода примерно равны месяцу.
Количество поисковых обращений также не даёт число разных людей. Один человек может искать несколько раз. Из этого показателя нельзя напрямую получить размер аудитории, клики на ваш сайт или покупки.
Как один поиск оказывается в трёх строках
Рассмотрим вымышленный журнал из восьми поисковых событий. ID нужны только для объяснения: это учебные данные, а не выгрузка Вордстата или статистика Беларуси.
Сравниваем три группы: A — запросы со словом кресло, B — со словами кресло минск, C — со словами офисное кресло. Для простоты все слова записаны в одной форме; морфологию, стоп-слова и операторы здесь не моделируем.
| Событие | Поисковая формулировка | Группы |
|---|---|---|
| E1 | купить кресло | A |
| E2 | купить кресло минск | A, B |
| E3 | офисное кресло | A, C |
| E4 | офисное кресло минск | A, B, C |
| E5 | купить офисное кресло минск | A, B, C |
| E6 | кресло минск | A, B |
| E7 | компьютерное кресло минск | A, B |
| E8 | купить стол минск | — |
В A семь событий, в B пять, в C три. Сумма счётчиков — 7 + 5 + 3 = 15, но хотя бы в одну группу попали только семь событий. E4 и E5 учтены в каждой из трёх строк; остальные пересечения тоже добавляют повторный счёт. E8 не относится к выбранным группам.
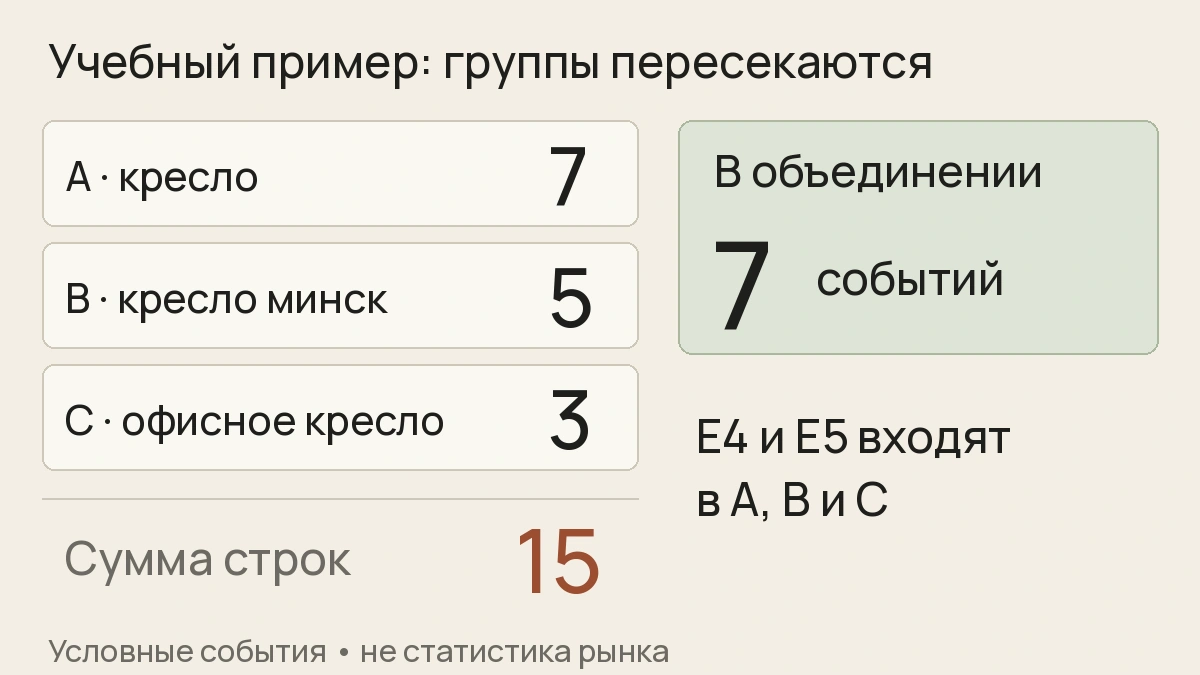
Здесь группы B и C целиком входят в A. Поэтому их добавление не увеличивает объединение. Это свойство заданного примера, а не разрешение брать самую большую строку за объём любого ядра: другие темы и синонимы могут добавлять отдельные запросы.
Суммировать показатели можно, когда подтверждены одинаковые условия измерения и отсутствие пересечений. Сам по себе разный текст строк этого не доказывает.
Почему чистка дублей не исправляет сумму
Фразы кресло, кресло минск и офисное кресло различаются. Они останутся разными строками после обычного удаления дублей, хотя соответствующие группы поисков пересекаются. Лемматизация решает ещё одну задачу: приводит словоформы к начальной форме. Она тоже не доказывает независимость частотностей.
Обработчик ключевых слов WiseLab помогает готовить и очищать формулировки, но не загружает поисковый спрос. Сгенерированная идея и измеренная частотность должны оставаться разными полями. Общий порядок поиска новых веток есть в основном ответе о расширении семантического ядра.
В N-грамм-анализе рекламных запросов повторный счёт можно устранять по исходным строкам отчёта, если они доступны. Сводная таблица частотностей по трём маскам не раскрывает, сколько событий у них общих. Поэтому вычитать произвольный «процент дублей» или восстанавливать точное объединение только из трёх чисел нельзя. В учебном примере ответ известен благодаря специально заданному журналу событий.
Операторы меняют состав измеряемой группы
В документации операторов кавычки ограничивают количество слов, ! фиксирует форму слова, квадратные скобки — порядок. Поэтому купить кресло и "купить кресло" описывают разные условия. Кавычки сами по себе не фиксируют ни порядок, ни все словоформы.
Храните выражение вместе с операторами в исходном виде. Если при чистке убрать кавычки, минус-слова или !, подпись строки перестанет объяснять сохранённое число. Повторное измерение после изменения выражения записывайте отдельно.
Что принять вместо общего числа «спроса»
Попросите у автора таблицы исходные выражения, дату получения, вкладку, видимый период, регион, устройства и название показателя. Для каждой группы сохраните самостоятельную оценку и отметку о возможном пересечении с соседними. Числа, снятые при разных условиях, сначала разделите на сопоставимые срезы.
Когда нужна оценка категории, задайте границы предложения и подходящие исходные темы. Проверьте, какие уточнения уже вложены в широкие группы, какие добавляют другую задачу и какие вообще не относятся к ассортименту. Без доказанной независимости оставляйте оценки по группам; общий итог помечайте как нерассчитанный. Это точнее, чем показывать аккуратную сумму с неизвестным повторным счётом.
Для бюджета подготовьте отдельный сценарий: доступные показы, доля переходов, цена клика и конверсия требуют своих оснований. Умножение суммы пересекающихся частотностей на условный CTR сохраняет исходную ошибку.
После выбора веток свяжите их с предложением, группами и посадочными по протоколу приёмки семантического ядра. Итог проверки частотностей — таблица с понятными условиями измерения и границами вывода. Она помогает выбрать направление работы, но не обещает количество клиентов.
Источники
Материал подготовлен редакцией WiseLab с помощью AI. Источники и фактические утверждения проверены при подготовке.
Что думаете?
Загружаем комментарии…